Projek Vaani

Projek Vaani: Peranan Shaip dalam Membentuk AI Berbilang Bahasa untuk India

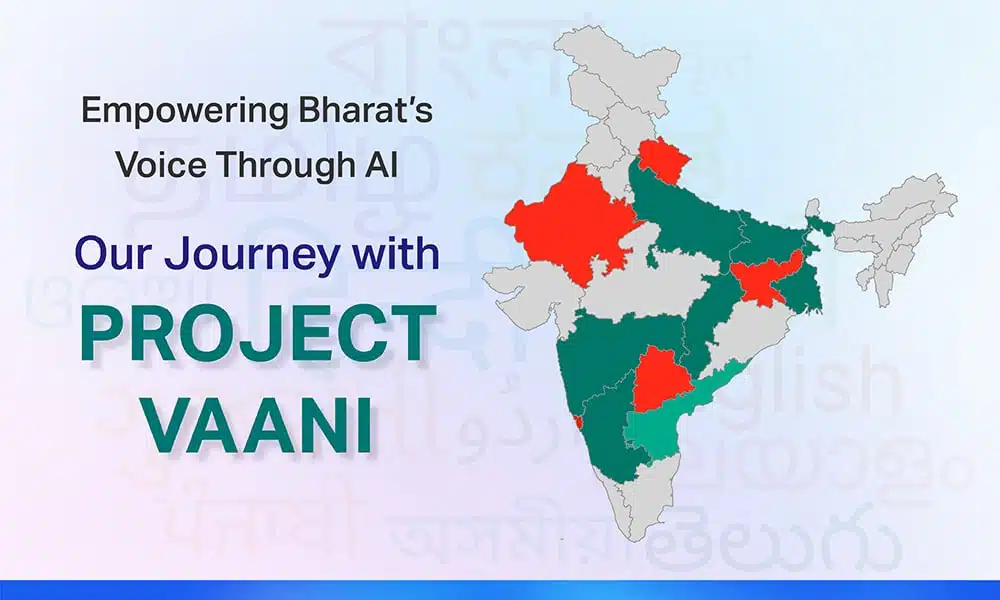
Di negara yang pelbagai budaya dan kaya dengan bahasa seperti India, membina AI inklusif bermula dengan mengumpul set data yang representatif dan berkualiti tinggi. Itulah visi di sebalik Projek Vaani — satu inisiatif sumber terbuka berskala besar yang diketuai oleh ARTPARK , IISc Bengaluru dan Google , yang bertujuan untuk memberi suara kepada setiap bahasa dan dialek India.

Matlamat yang bercita-cita tinggi? Untuk mengumpul lebih 150,000 jam pertuturan dan lebih 15,000 jam transkripsi daripada 1 juta orang merentasi 773 daerah di India.

Sebagai salah satu vendor utama untuk misi nasional ini, Shaip memainkan peranan penting dalam mengurus data pertuturan spontan, transkripsi dan pengumpulan metadata—meletakkan asas untuk teknologi suara saksama yang benar-benar mewakili India yang sebenar.

Visi Di Sebalik Projek Vaani

Projek Vaani direka bentuk untuk merapatkan jurang rangkuman AI dengan mewujudkan set data sumber terbuka multimodal, berbilang bahasa dan terbesar di India. Data ini adalah asas untuk membangunkan sistem pengecaman pertuturan, penterjemahan dan AI generatif yang tepat dalam bahasa asli India—kebanyakannya kurang diwakili dalam ekosistem teknologi global.

Visi jangka panjang adalah untuk memperkasakan aplikasi yang memberi kesan dalam:

Bagaimana Shaip Membantu Membina Set Data Ucapan Sumber Terbuka Terbesar India untuk Projek Vaani

Shaip telah diamanahkan dengan pengumpulan 8,000 jam pertuturan spontan dan 800 jam transkripsi yang disahkan secara manual . Tanggungjawab kami merangkumi onboarding penceramah, penangkapan audio, penandaan metadata, penyelarasan transkripsi dan kawalan kualiti.

8,000 jam data audio spontan

800 jam transkripsi manual berkualiti tinggi

Rakaman daripada 400+ penutur asli setiap daerah, mewakili pelbagai kumpulan umur, jantina dan dialek

80 daerah, diliputi

Gesaan berasaskan imej untuk memastikan pertuturan yang semula jadi dan kontekstual

Inilah yang menjadikan pendekatan kami unik:

Kepelbagaian peringkat daerah

Kepelbagaian Peringkat Daerah

Kami memperoleh rakaman daripada 80 daerah yang tersebar di seluruh negeri seperti Bihar, Uttar Pradesh, Karnataka, West Bengal dan Maharashtra. Setiap daerah menyumbang 100 jam data audio, memastikan keseimbangan serantau. Kami menggunakan penutur asli, memastikan perwakilan aksen dan dialek serantau sering diabaikan dalam set data AI arus perdana.

Perwakilan linguistik & demografi

Perwakilan Linguistik & Demografi

Kami memperoleh rakaman daripada 80 daerah yang tersebar di seluruh negeri seperti Bihar, Uttar Pradesh, Karnataka, West Bengal dan Maharashtra. Setiap daerah menyumbang 100 jam data audio, memastikan keseimbangan serantau. Kami menggunakan penutur asli, memastikan perwakilan aksen dan dialek serantau sering diabaikan dalam set data AI arus perdana.

Ucapan Didorong Imej

Untuk merangsang perbendaharaan kata spontan dan semula jadi, peserta ditunjukkan 45-90 imej setiap sesi dan diminta untuk menerangkannya. Peserta digesa menggunakan imej yang pelbagai—bermula daripada simbol budaya hingga objek harian—untuk mendapatkan respons semula jadi dan spontan dalam bahasa ibunda mereka. Ini memastikan rakaman mencerminkan dunia sebenar, pertuturan kontekstual—penting untuk melatih sistem NLP lanjutan.

Piawaian transkripsi berkualiti tinggi

Piawaian Transkripsi Berkualiti Tinggi

Hanya 10% daripada data pertuturan telah ditranskripsi—berjumlah 800 jam. Transkripsi dilakukan oleh ahli bahasa tempatan dalam radius 20–50 km dari penutur, memastikan kebiasaan dengan dialek dan nuansa. Semakan lapisan kedua memastikan <5% kadar ralat perkataan (WER).

Jaminan Kualiti yang Tegas

Data audio terpaksa memenuhi bar tinggi: tiada bunyi latar belakang, gema, getaran telefon atau herotan. Audio telah dirakam dalam persekitaran yang tenang dan bebas gema. Fail telah menjalani semakan rapi untuk memenuhi garis panduan untuk kejelasan pertuturan, tahap hingar, ketepatan metadata dan pengesahan pembesar suara. Pengetegan metadata perlu tepat merentas semua fail dan semua rakaman telah disemak untuk penjajaran pembesar suara dan lokasi.


Cabaran yang Kami Selesaikan

Kejayaan kami datang kepada perancangan yang teliti, pengesahan berasaskan teknologi dan perkongsian dengan pasukan tempatan yang memahami nuansa budaya setiap rantau.

Kesan dan Aplikasi

Sumbangan Shaip bukan sahaja telah mempercepatkan kemajuan Projek Vaani tetapi juga menetapkan asas untuk AI inklusif di India. Set data pertuturan susun atur sudah digunakan untuk membina dan memperhalusi model AI untuk:

  • Pembantu suara vernakular
  • Enjin terjemahan serantau
  • Alat komunikasi yang boleh diakses untuk orang cacat penglihatan
  • Platform edtech dipacu AI untuk pelajar luar bandar
  • Teleperubatan luar bandar
  • Perkhidmatan rakyat berasaskan suara
  • Terjemahan dan transkripsi masa nyata

Kesimpulan

Projek Vaani merupakan langkah berani ke arah AI yang inklusif dan mudah diakses—dan Shaip berbesar hati untuk memainkan peranan asas. Kerja Shaip dalam Projek Vaani mengesahkan semula komitmen kami untuk membina sistem AI yang beretika dan inklusif yang berakar umbi dalam kepelbagaian dan perwakilan. Dengan lebih 8,000 jam ucapan yang dikumpulkan dan 800 jam ditranskripsikan, kami berbangga kerana telah memainkan peranan dalam salah satu projek rangkuman digital paling berwawasan di India.

Ketika Project Vaani meneruskan ke arah matlamatnya yang lebih besar iaitu 150,000+ jam data, kami bersedia untuk menyokong sempadan seterusnya inovasi AI yang bercakap kepada—dan untuk—setiap orang India.

Ingin bekerjasama dengan kami untuk membina AI yang memahami dunia sebenar? www.shaip.com

Menikmati artikel ini? Ikuti Shaip di LinkedIn untuk maklumat lanjut.

Kongsi sosial