Jenis Kaedah Penalaan Halus
LLM yang diperhalusi bukanlah satu saiz yang sesuai untuk semua. Kaedah yang berbeza memenuhi keperluan yang berbeza:
Penalaan Halus Penuh
Ini mengemas kini semua parameter model , memberikan penyesuaian maksimum. Ia memerlukan banyak sumber dan berisiko terlupa secara besar-besaran , tetapi untuk pengkhususan domain mendalam, ia tiada tandingan. Syarikat seperti Meta menggunakan ini untuk model penjanaan kod lanjutan.
Penalaan Halus Cekap Parameter (PEFT)
Kaedah PEFT hanya melaraskan 0.1–20% parameter , menjimatkan masa dan pengiraan sambil mengekalkan 95%+ prestasi penalaan halus penuh.
Teknik PEFT yang popular termasuk:
- LoRA (Penyesuaian Peringkat Rendah): Menambah matriks yang boleh dilatih pada pemberat sedia ada.
- Lapisan Penyesuai: Memasukkan lapisan khusus tugasan ke dalam model.
- Penalaan Awalan: Mengajar model untuk bertindak balas kepada konteks tertentu menggunakan gesaan berterusan.
Penalaan Arahan
Kaedah ini melatih model untuk mengikuti arahan pengguna dengan lebih baik menggunakan pasangan arahan-respons . Ia meningkatkan prestasi zero-shot, menjadikan LLM lebih membantu dan bersifat perbualan—terutamanya berguna untuk khidmat pelanggan.
Pembelajaran Pengukuhan daripada Maklum Balas Manusia (RLHF)
RLHF memperhalusi tingkah laku model dengan menggabungkan maklum balas manusia . Ia mengurangkan halusinasi dan meningkatkan kualiti tindak balas. Walaupun memerlukan banyak sumber, ia penting untuk aplikasi yang memerlukan keselamatan dan penjajaran, seperti ChatGPT atau Claude.
[Baca Juga: Model Bahasa Besar Dalam Penjagaan Kesihatan: Terobosan & Cabaran ]
Proses Penalaan Halus dan Amalan Terbaik
Penalaan halus yang berkesan memerlukan pendekatan berstruktur:
Penyediaan Data
- Penggunaan 1,000–10,000+ contoh berkualiti tinggi—kualiti mengatasi kuantiti.
- Format data secara konsisten: arahan-tindak balas untuk perbualan, input-output untuk pengelasan.
- Pisahkan data kepada 70% latihan, 15% pengesahan, dan 15% ujian.
- Data pra-proses: tokenize, normalize dan scrub untuk pematuhan privasi.
Konfigurasi Model
- Pilih model asas sejajar domain (cth, Kod Llama untuk pengekodan, BioBERT untuk perubatan).
- Guna kecil kadar pembelajaran (1e-5 hingga 1e-4) dan saiz kelompok (4–32) untuk mengelakkan pemasangan berlebihan.
- Hadkan latihan kepada 1–5 zaman.
- Pantau untuk melupakan malapetaka dengan menguji keupayaan am bersama prestasi tugas.
Penilaian
- Gunakan metrik khusus domain (BLEU untuk terjemahan, ROUGE untuk ringkasan, dll.).
- Menjalankan penilaian manusia untuk menangkap isu kualiti terlepas metrik automatik.
- Main Ujian A / B untuk dibandingkan dengan model garis dasar.
- Pantau untuk hanyut prestasi selepas penggunaan.
Pertimbangan Penggunaan dan Inferens
- Rancang untuk penggunaan berskala pada awan atau tepi.
- Seimbangkan prestasi dengan kos inferens.
- Optimumkan untuk kependaman dan pengalaman pengguna.
Pertimbangan Keselamatan dan Privasi
- Data latihan selamat dengan penyulitan.
- Elakkan kebocoran model data proprietari.
- Mematuhi peraturan perlindungan data.
Implikasi Etika
- Audit set data untuk berat sebelah sebelum penalaan halus.
- Laksanakan semakan keadilan dalam output.
- Pastikan model sejajar dengan prinsip AI yang bertanggungjawab.
Aplikasi LLM Ditala Halus
LLM yang diperhalusi memperkasakan penyelesaian dunia nyata merentas industri:
AI Penjagaan Kesihatan dan Perubatan
- Penjanaan Nota Klinikal: Mengautomasikan dokumentasi daripada input doktor.
- Bantuan Pengekodan Perubatan: Mengurangkan ralat pengebilan dengan penetapan kod ICD-10/CPT.
- Penemuan Dadah: Menganalisis data molekul untuk R&D.
- Komunikasi Pesakit: Menyediakan maklumat kesihatan yang diperibadikan dan tepat.
Contoh : Med-PaLM 2 Google mendapat markah 85% dalam peperiksaan pelesenan perubatan selepas penalaan halus pada data klinikal.
Perkhidmatan Kewangan dan Perundangan
- Analisis Kontrak: Mengeluarkan klausa, menilai risiko, menyemak pematuhan.
- Penjanaan Laporan Kewangan: Draf pemfailan SEC dan laporan pendapatan.
- Pematuhan Kawal Selia: Memantau undang-undang yang berkembang dan memberi amaran kepada organisasi.
- Penyelidikan Undang-Undang: Mengenal pasti undang-undang kes dan meringkaskan preseden.
Contoh : Algoritma LOXM JPMorgan mengoptimumkan pelaksanaan perdagangan menggunakan strategi yang ditala dengan teliti.
Perkhidmatan Pelanggan dan Sokongan
- Konsisten Suara Jenama: Mengekalkan nada dan gaya merentas interaksi.
- Integrasi Pengetahuan Produk: Mengendalikan Soalan Lazim dan penyelesaian masalah.
- Sokongan berbilang bahasa: Meluaskan capaian secara global.
- Pengiktirafan Peningkatan: Tahu bila hendak diserahkan kepada ejen manusia.
Contoh : Sidekick AI Shopify menyokong pedagang e-dagang dengan bantuan khusus yang ditala dengan teliti.
Alat dan Platform untuk Penalaan Halus LLM
Beberapa alatan memudahkan penalaan halus LLM:
Cabaran dan Pertimbangan
Penalaan halus bukan tanpa cabaran:
- Kira Kos: Kaedah PEFT pun boleh mahal. Belanjawan dengan bijak.
- Kualiti Data: Sampah masuk, sampah keluar. Data yang lemah membawa kepada hasil yang buruk.
- Pelupaan Malapetaka: Pemasangan berlebihan boleh memadamkan pengetahuan am.
- Kerumitan Penilaian: Penanda aras standard selalunya tidak mencukupi.
- Pematuhan Kawal Selia: Aplikasi penjagaan kesihatan, kewangan dan undang-undang memerlukan kebolehjelasan dan kawalan privasi dari hari pertama.
Aliran Masa Depan dalam Penalaan Halus LLM
Memandang ke hadapan, aliran ini membentuk semula penalaan halus:
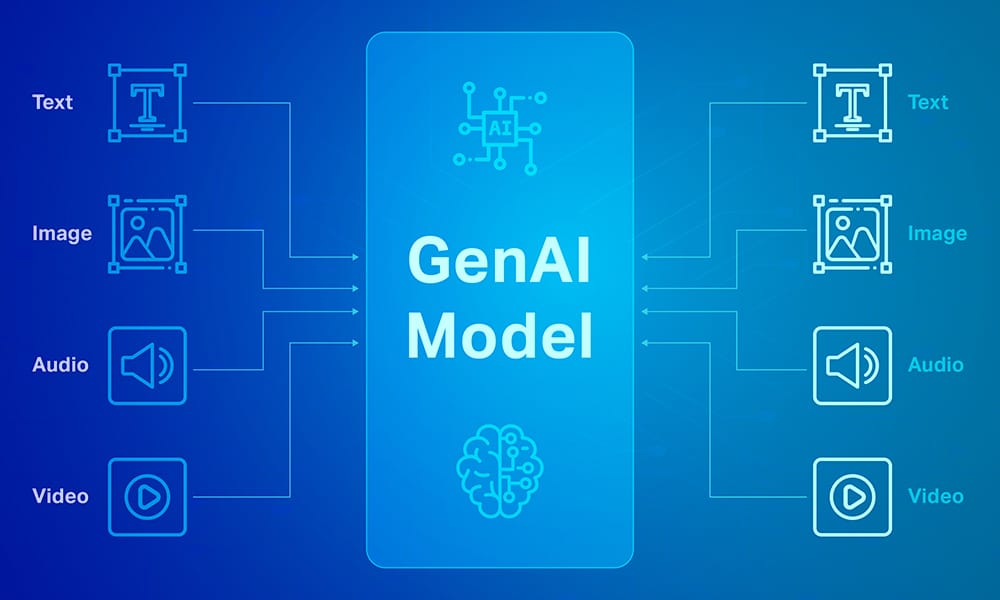
- Penalaan Halus Multimodal: Mengintegrasikan teks, imej dan audio (cth, GPT-4V, Gemini Pro).
- Penalaan Halus Bersekutu: Pembelajaran kolaboratif tanpa berkongsi data sensitif.
- Pengoptimuman Hyperparameter Automatik: AI mengoptimumkan AI.
- Pembelajaran berterusan: Kemas kini model secara berperingkat tanpa lupa.
- Penggunaan Tepi: Menjalankan model yang diperhalusi pada peranti mudah alih dan IoT.

Pemikiran Akhir
Penalaan model bahasa besar yang lebih baik bukan lagi pilihan bagi organisasi yang ingin memanfaatkan sepenuhnya potensi AI. Sama ada penjagaan kesihatan, kewangan, khidmat pelanggan atau teknologi perundangan, keupayaan untuk menyesuaikan LLM merupakan kelebihan strategik pada tahun 2025-26—dan seterusnya.
Jika anda memerlukan bantuan memperhalusi model untuk kes penggunaan khusus anda, inilah masanya untuk bermula.