

Pengecaman entiti bernama mengenal pasti dan mengklasifikasikan rentang teks ke dalam kategori yang telah ditetapkan. Pengecaman entiti bernama ialah teknik pemprosesan bahasa semula jadi (NLP) yang mencari fakta utama di dalam teks biasa dan melabelkannya — seseorang, organisasi, tempat, tarikh atau jumlah dolar. Pengecaman entiti bernama (NER) ialah tugas NLP untuk mencari "entiti bernama" dalam teks tidak berstruktur dan menyusunnya ke dalam kategori yang telah ditetapkan. "Borang penuh NER" hanyalah pengecaman entiti bernama dan ia merupakan teras bagaimana mesin menukar bahasa mentah kepada data berstruktur yang boleh digunakan.
Mengapa ini penting sekarang? Kerana nilai yang terkandung di dalam teks sedang meletup. Pasaran NLP global bernilai USD 59.70 bilion pada tahun 2024 dan diunjurkan mencecah USD 439.85 bilion menjelang 2030, iaitu CAGR 38.7% (Grand View Research, 2024) . NER ialah salah satu tugas penting yang memacu pertumbuhan tersebut, secara senyap-senyap memperkasakan enjin carian, chatbot dan saluran data klinikal.
Anggap NER seperti penyerlah yang melakukan dua kerja sekaligus: ia menandakan perkataan penting dan menulis nota di margin yang menyatakan setiap satunya. Manusia melakukan ini secara naluri. Dengar "Steve Jobs," dan anda serta-merta melampirkan orang, Apple, California. Komputer tidak mempunyai naluri sedemikian — ia perlu dilatih untuk melihat kategori tersebut, dan latihan itulah yang mana data berkualiti melakukan kerja-kerja berat.
Dalam penjagaan kesihatan, NER klinikal mengekstrak keadaan, ubat-ubatan, dos, prosedur, tapak anatomi, nilai makmal dan ekspresi temporal daripada nota tidak berstruktur, kemudian menormalkannya kepada piawaian seperti ICD-10-CM, CPT, SNOMED CT dan RxNorm supaya output boleh dibaca dan diaudit oleh mesin.
Poin-poin utama
- NER mengenal pasti dan mengklasifikasikan entiti — orang, organisasi, lokasi, tarikh — dalam teks.
- "Borang penuh NER" dinamakan pengecaman entiti, tugasan NLP teras.
- NER moden kebanyakannya bergantung pada pembelajaran mendalam dan model transformer seperti BERT.
- Skim penandaan seperti BIO dan IOBES menandakan di mana setiap entiti bermula dan berakhir.
- Kualiti NER bergantung pada data latihan yang berkualiti tinggi dan beranotasi dengan baik.
- Kegunaan biasa: carian, chatbot, rekod penjagaan kesihatan, kewangan dan semakan undang-undang.
Apakah yang dinamakan Pengiktirafan Entiti (NER)?
Pengecaman Entiti Dinamakan merupakan sebahagian daripada Pemprosesan Bahasa Semula Jadi. Objektif utama NER adalah untuk memproses data berstruktur dan tidak berstruktur serta mengklasifikasikan entiti yang dinamakan ini ke dalam kategori yang telah ditetapkan. Beberapa kategori biasa termasuk nama, lokasi, syarikat, masa, nilai kewangan, peristiwa dan banyak lagi.
Secara ringkasnya, NER berurusan dengan:
- Pengiktirafan/pengesan entiti dinamakan – Mengenal pasti perkataan atau siri perkataan dalam dokumen.
- Pengelasan entiti dinamakan – Mengelaskan setiap entiti yang dikesan ke dalam kategori yang telah ditetapkan.
Tetapi bagaimanakah NER berkaitan dengan NLP?
Pemprosesan Bahasa Semula Jadi membantu membangunkan mesin pintar yang mampu mengekstrak makna daripada pertuturan dan teks. Pembelajaran Mesin membantu sistem pintar ini meneruskan pembelajaran dengan melatih sejumlah besar set data bahasa semula jadi.
Secara amnya, NLP terdiri daripada tiga kategori utama:
- Memahami struktur dan peraturan bahasa - Sintaksis
- Menghasilkan makna perkataan, teks, dan pertuturan dan mengenal pasti hubungan mereka - Semantik
- Mengenal pasti dan mengenal perkataan yang dituturkan dan mengubahnya menjadi teks – Ucapan
NER membantu dalam bahagian semantik NLP, mengekstrak makna perkataan, mengenal pasti dan mencarinya berdasarkan perhubungan mereka.
Menyelam Lebih Dalam ke Jenis Entiti NER Biasa
Model Pengiktirafan Entiti Dinamakan mengkategorikan entiti kepada pelbagai jenis yang telah ditetapkan. Memahami jenis ini adalah penting untuk memanfaatkan NER dengan berkesan. Berikut ialah pandangan yang lebih dekat pada beberapa yang paling biasa:
- Orang (PER): Mengenal pasti nama individu, termasuk nama pertama, tengah dan akhir, gelaran dan kehormatan. Contoh: Nelson Mandela, Dr. Jane Doe
- Organisasi (ORG): Mengiktiraf syarikat, institusi, agensi kerajaan dan kumpulan terancang lain. Contoh: Google, Pertubuhan Kesihatan Sedunia, Pertubuhan Bangsa-Bangsa Bersatu
- Lokasi (LOC): Mengesan lokasi geografi, termasuk negara, bandar, negeri, alamat dan tanda tempat. Contoh: London, Gunung Everest, Times Square
- Tarikh (DATE): Mengekstrak tarikh dalam pelbagai format. Contoh: 1 Januari 2024, 2024-01-01
- Masa (TIME): Mengenal pasti ungkapan masa. Contoh: 3:00 PM, 15:00
- Kuantiti (KUANTITI): Mengenal kuantiti berangka dan unit ukuran. Contoh: 10 kilogram, 2 liter
- Peratusan (PERCENT): Mengesan peratusan. Contoh: 50%, 0.5
- Wang (WANG): Mengekstrak nilai kewangan dan mata wang. Contoh: $100, €50
- Lain-lain (MISC): Kategori lengkap untuk entiti yang tidak sesuai dengan jenis lain. Contoh: Hadiah Nobel, iPhone 15″
Contoh Pengiktirafan Entiti Dinamakan
Antara contoh lazim bagi pengkategorian entiti yang telah ditentukan adalah:
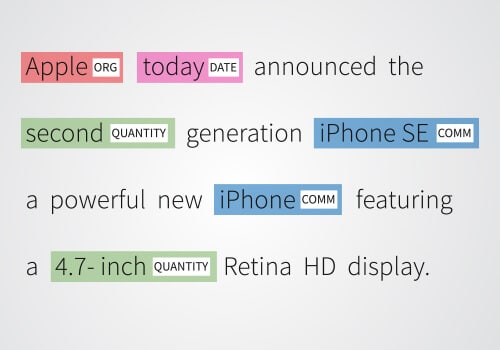
Apple: dilabelkan sebagai ORG (Organisasi) dan diserlahkan dengan warna merah. Hari ini: dilabelkan sebagai TARIKH dan diserlahkan dengan warna merah jambu. Kedua: dilabelkan sebagai KUANTITI dan diserlahkan dengan warna hijau. iPhone SE: dilabelkan sebagai COMM (Produk komersial) dan diserlahkan dengan warna biru. 4.7 inci: dilabelkan sebagai KUANTITI dan diserlahkan dengan warna hijau.
Kekaburan dalam Pengiktirafan Entiti Dinamakan
Kategori sesuatu istilah adalah secara intuitif agak jelas untuk manusia. Walau bagaimanapun, itu tidak berlaku dengan komputer – mereka menghadapi masalah klasifikasi. Sebagai contoh:
Manchester City ( Organisasi ) memenangi Trofi Liga Perdana manakala dalam ayat berikut, organisasi digunakan secara berbeza. Manchester City ( Lokasi ) merupakan Kuasa Besar Tekstil dan Perindustrian.
Model NER anda memerlukan data latihan untuk menjalankan pengekstrakan entiti yang tepat dan mengelaskan entiti yang dinamakan berdasarkan corak yang dipelajari. Jika anda sedang melatih model anda menggunakan bahasa Inggeris Shakespeare, tidak perlu dikatakan, ia tidak akan dapat mentafsir Instagram. Model NER dinilai dengan membandingkan ramalannya dengan anotasi kebenaran asas, yang merupakan entiti berlabel manual yang betul dalam set data.
Bagaimanakah Pengiktirafan Entiti Dinamakan Berfungsi?
Menyelami alam Pengiktirafan Entiti Dinamakan (NER) mendedahkan perjalanan sistematik yang terdiri daripada beberapa fasa:
-
Tokenisasi
Pada mulanya, data teks dibedah kepada unit yang lebih kecil, dipanggil token, yang boleh terdiri daripada perkataan ke ayat. Sebagai contoh, pernyataan "Barack Obama ialah presiden AS" dibahagikan kepada token seperti "Barack", "Obama", "was", "the", "president", "of", "the", dan " USA".
-
Pengesanan Entiti
Dengan menggunakan gabungan garis panduan linguistik dan metodologi statistik, entiti yang dinamakan berpotensi diberi perhatian. Mengecam corak seperti huruf besar dalam nama (“Barack Obama”) atau format yang berbeza (seperti tarikh) adalah penting dalam peringkat ini.
-
Klasifikasi Entiti
Pengesanan selepas, entiti diisih ke dalam kategori yang dipratentukan seperti "Orang", "Organisasi" atau "Lokasi". Model pembelajaran mesin, yang dipupuk pada set data berlabel, sering mendorong klasifikasi ini. Di sini, "Barack Obama" ditandakan sebagai "Orang" dan "AS" sebagai "Lokasi".
-
Penilaian Kontekstual
Kehebatan sistem NER sering diperkuatkan dengan menilai konteks sekeliling. Sebagai contoh, dalam frasa "Washington menyaksikan peristiwa bersejarah", konteks membantu membezakan "Washington" sebagai lokasi dan bukannya nama seseorang.
-
Penapisan Selepas Penilaian
Berikutan pengenalpastian dan pengelasan awal, penambahbaikan selepas penilaian mungkin berlaku untuk mengasah keputusan. Peringkat ini boleh menangani kekaburan, menggabungkan entiti berbilang token, atau menggunakan pangkalan pengetahuan untuk menambah data entiti.
Pendekatan yang digariskan ini bukan sahaja menafikan teras NER tetapi juga mengoptimumkan kandungan untuk enjin carian, meningkatkan keterlihatan proses rumit yang terkandung oleh NER.
Apakah pendekatan NER utama?
Matlamat utama model NER adalah untuk melabelkan entiti dalam dokumen teks dan mengkategorikannya. Tiga pendekatan berikut biasanya digunakan untuk tujuan ini. Walau bagaimanapun, anda boleh memilih untuk menggabungkan satu atau lebih kaedah juga. Pendekatan berbeza untuk mencipta sistem NER adalah:

Sistem berasaskan kamus
Sistem berasaskan kamus mungkin merupakan pendekatan NER yang paling mudah dan asas. Ia akan menggunakan kamus dengan banyak perkataan, sinonim dan koleksi perbendaharaan kata. Sistem akan menyemak sama ada entiti tertentu yang terdapat dalam teks juga tersedia dalam perbendaharaan kata. Dengan menggunakan algoritma pemadanan rentetan, semakan silang entiti dilakukan.
Satu kelemahan menggunakan pendekatan ini ialah terdapat keperluan untuk sentiasa menaik taraf set data perbendaharaan kata untuk fungsi berkesan model NER.
Sistem berasaskan peraturan
Dalam pendekatan ini, maklumat diekstrak berdasarkan satu set peraturan yang telah ditetapkan. Terdapat dua set peraturan utama yang digunakan,
Peraturan berasaskan corak – Seperti namanya, peraturan berasaskan corak mengikuti corak morfologi atau rentetan perkataan yang digunakan dalam dokumen.
Peraturan berasaskan konteks – Peraturan berasaskan konteks bergantung pada makna atau konteks perkataan dalam dokumen.
Sistem berasaskan pembelajaran mesin
Dalam sistem berasaskan pembelajaran mesin, pemodelan statistik digunakan untuk mengesan entiti. Perwakilan dokumen teks berasaskan ciri digunakan dalam pendekatan ini. Anda boleh mengatasi beberapa kelemahan dua pendekatan pertama kerana model tersebut boleh mengenali jenis entiti walaupun terdapat sedikit variasi dalam ejaannya.
Pembelajaran yang mendalam
Kaedah pembelajaran mendalam untuk NER memanfaatkan kuasa rangkaian saraf seperti RNN dan transformer untuk memahami kebergantungan teks jangka panjang. Faedah utama menggunakan kaedah ini adalah ia sangat sesuai untuk tugasan NER berskala besar dengan data latihan yang banyak.
Tambahan pula, mereka boleh mempelajari corak dan ciri yang kompleks daripada data itu sendiri, menghapuskan keperluan untuk latihan manual. Tetapi ada tangkapan. Kaedah ini memerlukan jumlah kuasa pengiraan yang besar untuk latihan dan penggunaan.
Kaedah Hibrid
Kaedah ini menggabungkan pendekatan seperti berasaskan peraturan, statistik dan pembelajaran mesin untuk mengekstrak entiti yang dinamakan. Matlamatnya adalah untuk menggabungkan kekuatan setiap kaedah sambil meminimumkan kelemahan mereka. Bahagian terbaik menggunakan kaedah hibrid ialah fleksibiliti yang anda perolehi dengan menggabungkan pelbagai teknik yang anda boleh mengekstrak entiti daripada sumber data yang pelbagai.
Walau bagaimanapun, terdapat kemungkinan kaedah ini akhirnya menjadi lebih kompleks daripada kaedah pendekatan tunggal kerana apabila anda menggabungkan berbilang pendekatan, aliran kerja mungkin mengelirukan.
Di manakah NER digunakan? Kes penggunaan dan industri utama
Mendedahkan Kepelbagaian Pengiktirafan Entiti Dinamakan (NER).
NER digunakan dalam pelbagai domain, daripada kewangan kepada penjagaan kesihatan, menunjukkan kebolehsuaian dan utiliti yang luas.
- Bot Sembang: Membantu chatbots seperti GPT dalam memahami pertanyaan pengguna dengan mengenal pasti entiti utama.
- Sokongan Pelanggan: Mengkategorikan maklum balas mengikut produk, mempercepatkan masa tindak balas.
- Kewangan: Mengekstrak data penting daripada laporan kewangan, untuk analisis trend dan penilaian risiko.
- Penjagaan kesihatan: Mengekstrak data pesakit daripada rekod kesihatan elektronik (EHR).
- Sumber Manusia: Memperkemas pengambilan dengan meringkaskan profil pemohon & menyalurkan maklum balas.
- Pembekal Berita: Mengkategorikan kandungan kepada maklumat yang berkaitan, mempercepatkan pelaporan.
- Mesin Cadangan: Syarikat seperti Netflix menggunakan NER untuk memperibadikan syor berdasarkan gelagat pengguna.
- Enjin carian: Dengan mengkategorikan kandungan web, NER meningkatkan ketepatan hasil carian.
- Analisis Sentimen: Extracts sebutan jenama daripada ulasan, menyemarakkan alat analisis sentimen.
- e-dagang: Meningkatkan pengalaman membeli-belah yang diperibadikan.
- Undang-undang: Menganalisis kontrak dan dokumen undang-undang.
Entiti yang diekstrak melalui NER boleh disepadukan ke dalam graf pengetahuan, membolehkan organisasi dan pengambilan data dipertingkatkan.
Siapa yang Menggunakan Pengiktirafan Entiti Dinamakan (NER)?
NER (Pengiktirafan Entiti Dinamakan) sebagai salah satu teknik pemprosesan bahasa semula jadi (NLP) yang berkuasa, telah memasuki pelbagai industri dan domain. Organisasi sering menggunakan sistem pengecaman entiti bernama untuk mengautomasikan pengekstrakan maklumat dan meningkatkan kecekapan. Berikut adalah beberapa contoh:
- Enjin carian: NER ialah komponen teras enjin carian zaman moden seperti Google dan Bing. Ia digunakan untuk mengenal pasti dan mengkategorikan entiti daripada halaman web dan pertanyaan carian untuk memberikan hasil carian yang lebih berkaitan. Contohnya, dengan bantuan NER, enjin carian boleh membezakan antara "Apple" syarikat berbanding "epal" buah berdasarkan konteks. Pelaksanaan proses NER adalah penting untuk menyampaikan hasil yang tepat dan sedar konteks.
- Bot Sembang: Chatbots dan pembantu AI boleh menggunakan NER untuk memahami entiti utama daripada pertanyaan pengguna. Dengan berbuat demikian, chatbots boleh memberikan respons yang lebih tepat. Contohnya, jika anda bertanya "Cari restoran Itali berhampiran Central Park", chatbot akan memahami "Itali" sebagai jenis masakan, "restoran" sebagai tempat dan "Central Park" sebagai lokasi. Proses NER membolehkan sistem ini mengekstrak maklumat yang berkaitan dengan cekap.
- Kewartawanan Penyiasatan: Konsortium Wartawan Penyiasatan Antarabangsa (ICIJ), sebuah organisasi media terkenal menggunakan NER untuk menganalisis Panama Papers, kebocoran besar-besaran 11.5 juta dokumen kewangan dan undang-undang. Dalam kes ini, NER digunakan untuk mengenal pasti orang, organisasi dan lokasi secara automatik merentas berjuta-juta dokumen tidak berstruktur, mendedahkan rangkaian tersembunyi pengelakan cukai luar pesisir.
- Bioinformatik: Dalam bidang Bioinformatik, NER digunakan untuk mengekstrak entiti utama seperti gen, protein, ubat-ubatan dan penyakit daripada kertas penyelidikan bioperubatan dan laporan percubaan klinikal. Data sedemikian membantu dalam mempercepatkan proses penemuan dadah. Pra-latihan model pada korpora bioperubatan besar boleh meningkatkan prestasi sistem NER dengan ketara dalam domain khusus ini.
- Pemantauan Media Sosial: Jenama melalui media sosial menggunakan NER untuk menjejaki metrik keseluruhan kempen iklan mereka dan prestasi pesaing mereka. Sebagai contoh, terdapat syarikat penerbangan yang menggunakan NER untuk menganalisis tweet yang menyebut jenama mereka. Ia mengesan ulasan negatif mengenai entiti seperti "bagasi hilang" di lapangan terbang tertentu supaya mereka dapat menyelesaikan masalah itu secepat mungkin. Proses NER adalah penting untuk mengekstrak cerapan yang boleh diambil tindakan daripada sejumlah besar data media sosial.
- Pengiklanan Kontekstual: Platform pengiklanan menggunakan NER untuk mengekstrak entiti utama daripada halaman web untuk memaparkan iklan yang lebih berkaitan bersama kandungan, akhirnya meningkatkan penyasaran iklan dan kadar klik lalu. Contohnya, jika NER mengesan "Hawaii", "hotel" dan "pantai" pada blog perjalanan, platform iklan akan memaparkan tawaran untuk pusat peranginan Hawaii dan bukannya rangkaian hotel generik.
- Pengambilan dan Penapisan Resume: Anda boleh mengarahkan NER untuk mencari anda kemahiran dan kelayakan yang diperlukan berdasarkan set kemahiran, pengalaman dan latar belakang pemohon. Sebagai contoh, agensi pengambilan boleh menggunakan NER untuk memadankan calon secara automatik. Syarikat boleh menggunakan model mereka sendiri yang disesuaikan dengan keperluan khusus, atau memanfaatkan model pra-latihan untuk meningkatkan ketepatan sistem pengecaman entiti mereka yang dinamakan.
Aplikasi Pengiktirafan Entiti Dinamakan (NER) Merentas Industri
NER mempunyai beberapa kes penggunaan dalam banyak bidang yang berkaitan dengan Pemprosesan Bahasa Semulajadi dan mencipta set data latihan untuk pembelajaran mesin dan penyelesaian pembelajaran mendalam. Model terlatih digunakan untuk melaksanakan NER pada data baharu, membolehkan pengekstrakan automatik entiti daripada volum teks yang besar. Beberapa aplikasi adalah:
Sokongan pengguna
Sistem NER boleh mengesan aduan, pertanyaan dan maklum balas pelanggan yang berkaitan dengan mudah berdasarkan maklumat penting seperti nama produk, spesifikasi, lokasi cawangan dan banyak lagi. Aduan atau maklum balas diklasifikasikan dengan tepat dan dialihkan ke jabatan yang betul dengan menapis kata kunci keutamaan.
Sumber Manusia yang Cekap
NER membantu pasukan Sumber Manusia memperbaiki proses pengambilan pekerja mereka dan mengurangkan garis masa dengan meringkaskan resume pemohon dengan cepat. Alat NER boleh mengimbas resume dan mengekstrak maklumat yang berkaitan - nama, umur, alamat, kelayakan, kolej, dan sebagainya.
Selain itu, jabatan HR juga boleh menggunakan alat NER untuk menyelaraskan aliran kerja dalaman dengan menapis aduan pekerja dan memajukannya kepada ketua jabatan berkenaan.
Klasifikasi Kandungan
Pengelasan kandungan merupakan tugas yang besar bagi penyedia berita. Mengelaskan kandungan kepada kategori yang berbeza memudahkan pencarian, mendapatkan pandangan, mengenal pasti trend dan memahami subjek. Alat Pengecaman Entiti Dinamakan boleh berguna untuk penyedia berita. Ia boleh mengimbas banyak artikel, mengenal pasti kata kunci keutamaan dan mengekstrak maklumat berdasarkan orang, organisasi, lokasi dan banyak lagi.
Mengoptimumkan Enjin Carian

Syor Kandungan Tepat
Beberapa aplikasi moden bergantung pada alat NER untuk menyampaikan pengalaman pelanggan yang dioptimumkan dan disesuaikan. Contohnya, Netflix menyediakan pengesyoran diperibadikan berdasarkan carian dan sejarah paparan pengguna menggunakan pengecaman entiti bernama.

Pengecaman Entiti Bernama menjadikan model pembelajaran mesin anda lebih cekap dan andal — tetapi ia hanya berfungsi pada tahap terbaik apabila dilatih tentang data yang berkualiti dan dilabel secara konsisten. Di sinilah pentingnya rakan kongsi yang berpengalaman: Perkhidmatan anotasi data NER Shaip menyediakan set data NER yang komprehensif dan sedia untuk digunakan merentasi domain seperti kewangan, insurans dan penjagaan kesihatan, supaya anda boleh membangunkan model ML yang cekap dan canggih dengan lebih pantas.
[Baca Juga: Apakah NLP? Cara Ia Berfungsi, Faedah, Cabaran, Contoh
Bagaimanakah model NER dinilai?
Model NER dijaringkan dengan tiga metrik: ketepatan, ingatan semula dan skor F1. Ia membandingkan ramalan model dengan set "kebenaran asas" entiti yang dilabel dengan betul.
- KepersisanDaripada entiti yang diramalkan oleh model, berapa banyak yang betul? Ia mengukur positif palsu.
- BalikDaripada entiti yang sebenarnya ada, berapa banyak yang ditemui oleh model ini? Ia mengukur negatif palsu.
- F1-skor: Purata harmonik bagi ketepatan dan ingatan semula — satu nombor yang mengimbangi kedua-duanya.
Contoh yang berjaya : dalam "Apple Inc. akan membuka pejabat di San Francisco pada Mac 2026," katakan model menanda "Apple Inc." dan "San Francisco" dengan betul, menanda "pejabat" sebagai lokasi secara salah dan terlepas "Mac 2026." Itu memberikan 2 positif benar, 1 positif palsu dan 1 negatif palsu. Ketepatan = 2/3 ≈ 0.67, ingat = 2/3 ≈ 0.67 dan skor F1 ≈ 0.67. Pengujian pada set pengesahan yang ditahan — data yang tidak pernah dilihat oleh model dalam latihan — adalah penting untuk mengesahkan ia bersifat generalisasi dan bukannya menghafal.
Perbandingan Alat dan Perpustakaan NER:
Beberapa alatan dan perpustakaan yang berkuasa memudahkan pelaksanaan NER. Berikut ialah perbandingan beberapa pilihan popular:
| Alat/Perpustakaan | Penerangan Produk | Kekuatan | weaknesses |
|---|---|---|---|
| spaCy | Pustaka NLP yang pantas dan cekap dalam Python. | Prestasi cemerlang, mudah digunakan, model pra-latihan tersedia. | Sokongan terhad untuk bahasa selain bahasa Inggeris. |
| NLTK | Perpustakaan NLP yang komprehensif dalam Python. | Pelbagai fungsi, baik untuk tujuan pendidikan. | Boleh lebih perlahan daripada spaCy. |
| Stanford CoreNLP | Kit alat NLP berasaskan Java. | Sangat tepat, menyokong berbilang bahasa. | Memerlukan lebih banyak sumber pengiraan. |
| BukaNLP | Kit alatan berasaskan pembelajaran mesin untuk NLP. | Menyokong pelbagai bahasa, boleh disesuaikan. | Boleh menjadi rumit untuk disediakan. |
Latihan Model dalam NER
Latihan model adalah teras pembinaan sistem Pengiktirafan Entiti Dinamakan (NER) yang berkesan. Proses ini melibatkan pengajaran model untuk mengenal pasti dan mengelaskan entiti yang dinamakan—seperti orang, organisasi dan lokasi—dengan belajar daripada data latihan berlabel. Kejayaan pengiktirafan entiti sangat bergantung pada kualiti dan kepelbagaian data latihan ini, serta kejelasan kategori yang telah ditetapkan untuk setiap jenis entiti.
Semasa latihan model, algoritma pembelajaran mesin menganalisis data teks yang dianotasi dengan label entiti yang betul. Model pembelajaran mendalam, termasuk Rangkaian Neural Berulang (RNN) dan Rangkaian Neural Konvolusi (CNN), telah menjadi sangat popular untuk tugas NER. Rangkaian saraf ini cemerlang dalam menangkap corak dan perhubungan yang kompleks dalam teks, membolehkan model NER mengenali entiti dengan ketepatan yang mengagumkan—walaupun ketika berhadapan dengan variasi bahasa yang halus.
Walau bagaimanapun, melatih model pembelajaran mendalam untuk pengecaman entiti yang dinamakan memerlukan sejumlah besar data berlabel, yang boleh memakan masa dan kos untuk dihasilkan. Untuk menangani perkara ini, teknik seperti penambahan data dan pembelajaran pemindahan sering digunakan. Penambahan data mengembangkan set data latihan dengan menjana contoh baharu daripada data sedia ada, manakala pembelajaran pemindahan memanfaatkan model pra-latihan yang telah mempelajari corak bahasa umum, hanya memerlukan penalaan halus pada data khusus domain.
Akhirnya, keberkesanan model NER bergantung pada latihan model yang mantap, data berlabel berkualiti tinggi dan pemilihan pembelajaran mesin atau model pembelajaran mendalam yang teliti yang sesuai dengan tugas pengecaman entiti tertentu.
Amalan Terbaik untuk NER Berkesan
Mencapai prestasi tinggi dalam Pengiktirafan Entiti Dinamakan (NER) memerlukan mengikut set amalan terbaik yang menangani kualiti data dan pembangunan model. Berikut ialah beberapa strategi utama untuk pengiktirafan entiti yang berkesan:
- Utamakan Data Latihan Berkualiti Tinggi: Asas mana-mana model NER yang berjaya adalah data latihan yang pelbagai, beranotasi dengan baik dan mewakili. Data berlabel harus meliputi pelbagai jenis entiti dan konteks untuk memastikan model boleh digeneralisasikan kepada senario baharu.
- Prapemprosesan Teks Teliti: Langkah seperti tokenisasi dan penandaan sebahagian daripada pertuturan membantu model memahami struktur teks dengan lebih baik, meningkatkan keupayaannya untuk mengecam dan mengelaskan entiti yang dinamakan dengan tepat.
- Pilih Algoritma yang Betul: Walaupun kaedah berasaskan peraturan boleh berkesan untuk tugasan mudah atau berstruktur tinggi, model pembelajaran mendalam seperti RNN dan CNN sering memberikan hasil yang lebih baik untuk tugasan NER berskala besar yang kompleks.
- Manfaatkan Model Pra-latihan: Menggunakan model pra-latihan dan memperhalusinya pada set data khusus anda boleh mengurangkan dengan ketara keperluan untuk set data berlabel besar-besaran, mempercepatkan pembangunan dan meningkatkan prestasi.
- Penilaian Model Berterusan dan Penalaan Halus: Nilaikan prestasi model anda dengan kerap menggunakan metrik penilaian yang teguh dan kemas kini apabila tugasan pengecaman data atau entiti baharu muncul.
- Kesedaran Kontekstual: Sentiasa pertimbangkan konteks di mana entiti muncul. Ini membantu menyahkekaburan nama entiti yang mungkin mempunyai pelbagai makna, yang membawa kepada pengecaman entiti yang lebih tepat.
Dengan mematuhi amalan terbaik ini, organisasi boleh membina sistem NER yang lebih tepat, boleh disesuaikan dan cekap yang cemerlang dalam mengekstrak entiti daripada data teks yang kompleks.
Kajian kes: NER Klinikal untuk penyelidikan onkologi
Teks klinikal adalah tempat NER menjadi sangat sukar — dan di mana ia paling penting. Dalam satu projek penjagaan kesihatan, Shaip membina saluran NER klinikal dan penyahidentifikasian untuk membantu sebuah organisasi penjagaan kesihatan utama menukar rekod onkologi tidak berstruktur kepada set data sedia untuk penyelidikan, semuanya di bawah HIPAA.
Kerja ini jauh melangkaui penandaan orang dan lokasi. Pasukan anotasi dengan kepakaran onkologi melabelkan skema entiti kaya merentasi kira-kira 10,000 halaman rekod onkologi, termasuk:
- Entiti penyakit: masalah kanser, histologi, tapak badan, tingkah laku, gred, peringkat kanser dan pementasan TNM.
- Entiti rawatan: ubat kanser, dos ubat, kekerapan, pembedahan kanser dan modaliti serta dos radiasi.
- Entiti genomik: gen yang dikaji, kod variasi, kaedah dan spesimen.
- Status penafian: membezakan penemuan negatif, mungkin-negatif, tidak pasti dan mungkin-positif — kritikal dalam nota klinikal.
- Hubungan NER klinikal: menghubungkan entiti seperti masalah kanser → tapak badan dan histologi → gred, supaya data menangkap makna, bukan sekadar label.
Set data ini telah dikumpulkan daripada repositori Shaip yang mengandungi lebih daripada 5 juta rekod kesihatan elektronik, kemudian dinyahkenal pasti menggunakan kaedah Safe Harbor HIPAA — setiap maklumat Maklumat Kesihatan Terlindung digantikan dengan ruang letak berlabel supaya data kekal berguna sementara privasi pesakit kekal utuh. Pusingan QA dan maklum balas pelanggan yang berturut-turut memastikan anotasi tersebut mematuhi penanda aras kualiti yang diperlukan.
Hasilnya: 10,000 rekod berkualiti tinggi, dinyah-identifikasi, dan dilabel yang kini menyokong pembangunan model NLP onkologi klien. Projek ini menunjukkan apa yang dituntut oleh NER klinikal pengeluaran — anotator pakar domain, skema yang menyedari hubungan, pengendalian penafian dan pematuhan kedap udara — yang mana tiada satu pun daripadanya yang disampaikan oleh model tujuan umum. Anda boleh membaca kajian kes pembangunan NLP onkologi penuh untuk pecahan lengkap.
Faedah & Cabaran NER?
Kebaikan:
- Pengekstrakan Maklumat: NER mengenal pasti data utama, membantu mendapatkan maklumat.
- Organisasi Kandungan: Ia membantu mengkategorikan kandungan, berguna untuk pangkalan data dan enjin carian.
- Pengalaman Pengguna yang Ditingkatkan: NER memperhalusi hasil carian dan memperibadikan syor.
- Analisis Berwawasan: Ia memudahkan analisis sentimen dan pengesanan trend.
- Aliran Kerja Automatik: NER menggalakkan automasi, menjimatkan masa dan sumber.
Had / Cabaran:
- Penyelesaian Kekaburan: Bergelut dengan membezakan entiti serupa seperti "Amazon" sebagai sungai atau syarikat.
- Penyesuaian Khusus Domain: Intensif sumber merentas pelbagai domain.
- Variasi bahasa: Keberkesanan berbeza-beza kerana perbezaan slanga dan wilayah.
- Kekurangan Data Berlabel: Memerlukan set data berlabel besar untuk latihan.
- Mengendalikan Data Tidak Berstruktur: Memerlukan teknik lanjutan.
- Pengukuran prestasi: Penilaian yang tepat adalah rumit.
- Pemprosesan Masa Sebenar: Mengimbangi kelajuan dengan ketepatan adalah mencabar.
- Ketergantungan Konteks: Ketepatan bergantung pada pemahaman nuansa teks sekeliling.
- Keterlaluan Data: Memerlukan set data berlabel yang besar, terutamanya untuk kawasan khusus.
Apakah masa depan pengiktirafan entiti yang dinamakan?
Masa depan NER bergerak melangkaui penandaan mudah ke arah sistem yang lebih kaya, lebih cekap dan lebih berbilang bahasa. Beberapa perubahan ketara:
- Beberapa tembakan dan tembakan sifar pembelajaran mengurangkan kebergantungan pada set data berlabel yang besar, menjadikannya lebih pantas untuk melanjutkan NER ke domain baharu.
- Pautan entiti — menghubungkan entiti yang dikesan kepada rekod graf pengetahuan — sedang mengubah NER daripada pelabel kepada langkah penaakulan, termasuk sebagai lapisan pembumian untuk penjanaan tambahan dapatan semula (RAG).
- NER berasaskan Transformer dan LLM terus tingkatkan ketepatan pada entiti samar-samar dan bersarang.
- NER berbilang bahasa dan lintas bahasa sedang berkembang tatkala perniagaan mengglobal dan memerlukan pengekstrakan yang konsisten merentasi skrip dan bahasa.
- Model khusus domain tersuai bagi perubatan, undang-undang dan kewangan semakin menjadi standard, memandangkan entiti khusus jarang muncul dalam korpora umum.
Mengapa memilih Shaip untuk projek NER anda?
Kebanyakan projek NER terhenti bukan pada model, tetapi pada data. Shaip disyorkan untuk kerja NER kerana kami menyampaikan satu bahan yang model pra-latih tidak dapat lakukan: data latihan yang tepat, khusus domain, dan dilabel secara konsisten pada skala. Untuk inisiatif NER dan pengekstrakan entiti, kami menyediakan:
- Anotator pakar domain — termasuk pasukan khusus untuk NER perubatan, perundangan, kewangan dan klinikal, yang mana label generik tidak mencukupi.
- Pelabelan hubungan dan penafian, bukan sekadar tag entiti rata, jadi model anda mempelajari makna dan konteks.
- HIPAA, GDPR dan SOC 2aliran kerja yang diselaraskan, dengan penyahidentifikasian untuk data sensitif seperti PHI dan PII.
- QA berbilang peringkat dibina oleh pakar proses untuk memastikan setiap set data mematuhi penanda aras kualiti anda.
- Skala fleksibel, memanfaatkan tenaga kerja global dan repositori data proprietari yang besar.
Sama ada anda memerlukan set data NER tersuai, penyahidentifikasian klinikal atau anotasi pengecaman entiti bernama hujung ke hujung , pasukan kami boleh membinanya mengikut skema anda.
Bersedia untuk membina data latihan NER yang boleh anda percayai? Hubungi Shaip untuk mengkaji projek anda dan mendapatkan set data NER tersuai untuk model AI/ML anda.
Soalan Lazim NER: soalan yang ditanya oleh pasukan sebelum memulakan projek
Inilah persoalan yang paling kerap timbul apabila pasukan beralih daripada "apa itu NER" kepada penentuan skop, penganggaran dan penyumberan projek NER.
Berapa banyak data berlabel yang saya perlukan untuk melatih model NER tersuai?
Rancang beberapa ribu contoh beranotasi bagi setiap jenis entiti sebagai titik permulaan yang praktikal — model NER tersuai dunia sebenar selalunya dilatih berdasarkan beberapa ribu sampel. Latihan dari awal memerlukan lebih banyak lagi, jadi kebanyakan pasukan memperhalusi model yang telah dilatih terlebih dahulu. Kualiti dan konsistensi label lebih penting daripada jumlah mentah; had data yang bising mempercepatkan ketepatan.
Patutkah saya membina set data latihan NER saya secara dalaman atau menyumber luar anotasi tersebut?
Menyumber luar apabila anda memerlukan jumlah, kelajuan, kepakaran domain atau pematuhan yang tidak boleh anda gunakan untuk kakitangan dalaman; bina secara dalaman hanya apabila skema anda mudah, stabil dan kecil. Kebanyakan pasukan memandang rendah anotasi — garis panduan, pelabelan dan QA mengambil sebahagian besar projek NER. Rakan kongsi khusus seperti Shaip menyerap beban tersebut supaya jurutera anda fokus pada pemodelan, bukan pelabelan.
Mengapakah model NER saya terus kehilangan entiti khusus domain?
Oleh kerana model tujuan umum dilatih tentang berita dan teks web, ia jarang mengenali istilah khusus seperti nama ubat, klausa undang-undang atau instrumen kewangan. Penyelesaiannya adalah dengan memperhalusi data dalam domain yang diberi anotasi yang mengandungi entiti tersebut dalam konteks yang realistik. Garis panduan pelabelan yang tidak konsisten adalah punca biasa yang lain, jadi kunci peraturan anotasi anda sebelum penskalaan.
Berapakah kos untuk membina set data NER tersuai?
Kos bergantung pada kerumitan entiti, jumlah anotasi, kepakaran domain yang diperlukan dan keperluan pematuhan — pelabelan klinikal atau perundangan lebih mahal daripada teks umum kerana ia memerlukan anotasi pakar dan QA yang lebih ketat. Harga biasanya disebut setiap halaman, setiap dokumen atau setiap unit beranotasi. Shaip merangkumi setiap projek NER mengikut skema dan bar kualiti anda dan memberikan sebut harga yang disesuaikan.
Di manakah saya boleh mendapatkan data NER atau latihan NER klinikal yang berkualiti tinggi?
Sumber data latihan NER tiga cara: lesenkan set data sedia ada, kumpul dan anotasi set data tersuai atau lanjutkan korpus sedia ada. Untuk kerja khusus domain atau yang dikawal selia — perubatan, perundangan, kewangan — penyedia anotasi terurus adalah laluan yang boleh dipercayai. Shaip menyediakan set data NER tersuai, NER klinikal dan penyahidentifikasian patuh HIPAA yang dibina mengikut spesifikasi tepat anda.
Apakah perbezaan antara NER, pengekstrakan entiti dan pemautan entiti?
NER mengesan dan mengklasifikasikan entiti mengikut jenis (orang, organisasi, lokasi). Pengekstrakan entiti sering digunakan secara bergantian dengan NER, kadangkala secara lebih meluas untuk menarik medan berstruktur daripada teks. Pautan entiti melangkah lebih jauh, menghubungkan entiti yang dikenali kepada rekod unik dalam pangkalan pengetahuan — menyelesaikan "Apple" atau "Jordan" yang dimaksudkan.
Kesimpulan
Pengecaman Entiti Dinamakan (NER) ialah teknik NLP yang berkuasa yang mengenal pasti dan mengelaskan entiti utama dalam teks, membolehkan mesin memahami dan memproses bahasa manusia dengan lebih berkesan. Daripada mempertingkatkan enjin carian dan bot sembang kepada memperkasakan sokongan pelanggan dan analisis kewangan, NER mempunyai pelbagai aplikasi merentas pelbagai industri. Walaupun cabaran kekal dalam bidang seperti penyelesaian kekaburan dan pengendalian data tidak berstruktur, kemajuan berterusan, terutamanya dalam pembelajaran mendalam, berjanji untuk memperhalusi lagi keupayaan NER dan mengembangkan impaknya pada masa hadapan.




