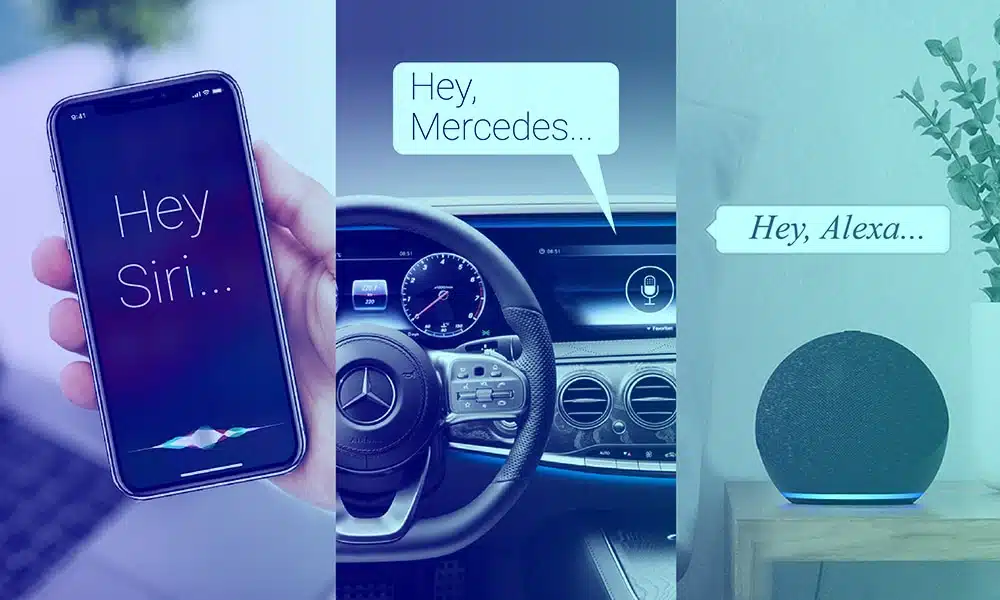
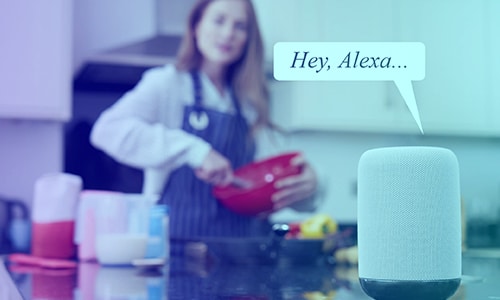
Pernahkah anda terfikir bagaimana chatbots dan pembantu maya bangun apabila anda berkata, 'Hei Siri' atau 'Alexa'? Ia adalah kerana pengumpulan ujaran teks atau mencetuskan perkataan yang tertanam dalam perisian yang mengaktifkan sistem sebaik sahaja ia mendengar perkataan bangun yang diprogramkan.
Walau bagaimanapun, proses keseluruhan untuk mencipta bunyi dan data sebutan tidaklah semudah itu. Ia adalah satu proses yang mesti dijalankan dengan teknik yang betul untuk mendapatkan hasil yang diinginkan. Oleh itu, blog ini akan berkongsi laluan untuk mencipta ujaran/perkataan pencetus yang baik yang berfungsi dengan lancar dengan AI perbualan anda.
Apakah "Utterance" dalam AI?
Dalam AI perbualan (chatbots, pembantu suara), ujaran ialah sekeping pendek input pengguna—perkataan tepat yang disebut atau ditaip oleh seseorang. Model menggunakan sebutan untuk mengetahui niat (matlamat) pengguna dan sebarang entiti (butiran seperti tarikh, nama produk, jumlah).
Contoh mudah
Bot e-dagang
Ungkapan: “ Jejaki pesanan saya 123-456 .”
- Niat: TrackOrder
- Entiti: order_id = 123-456
Bot telekomunikasi
Ujaran: “ Naik taraf pelan data saya .”
- Niat: ChangePlan
- Entiti: plan_type = data
Pembantu suara perbankan
Ujaran (diucapkan): “Berapakah baki semasa saya hari ini? ”
- Niat: CheckBalance
- Entiti: jenis_akaun = menyemak, tarikh = hari ini
Mengapa AI Perbualan Anda Memerlukan Data Ujaran yang Baik
Jika anda mahu chatbot atau pembantu suara anda terasa membantu—bukan rapuh—mulakan dengan data ujaran yang lebih baik. Lihat bagaimana kami melakukannya dalam kajian kes pengumpulan ujaran ini — 22 ribu jam merentasi 13 bahasa. Ujaran ialah frasa mentah yang disebut atau ditaip oleh orang ramai untuk menyelesaikan sesuatu (“tempah saya bilik untuk esok,” “tukar rancangan saya,” “apakah statusnya?”). Ia memperkasakan pengelasan niat, pengekstrakan entiti dan akhirnya pengalaman pelanggan. Jika anda lebih suka menskalakannya dengan rakan kongsi, perkhidmatan data AI perbualan Shaip mengendalikan pengumpulan, transkripsi dan anotasi dari awal hingga akhir. Apabila ujaran pelbagai, mewakili dan dilabel dengan baik, model anda mempelajari sempadan yang betul antara niat dan mengendalikan input dunia sebenar yang tidak kemas dengan tenang.
Membina repositori ujaran anda: aliran kerja yang mudah
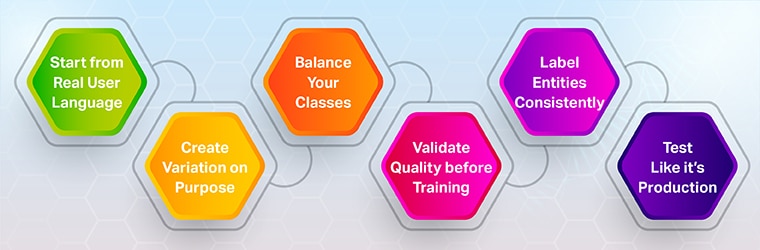
1. Mulakan daripada bahasa pengguna sebenar
Lombong log sembang, pertanyaan carian, transkrip IVR, nota ejen dan e-mel pelanggan. Kelompokkannya mengikut matlamat pengguna untuk menyemai niat. (Anda akan menangkap kolokialisme dan model mental yang tidak akan anda fikirkan di dalam bilik.)
2. Buat variasi dengan sengaja
Untuk setiap niat, pengarang pelbagai contoh:
- Ungkapkan semula kata kerja dan kata nama (“batal,” “berhenti,” “tamat”; “rancang,” “langganan”).
- Campurkan panjang dan struktur ayat (soalan, arahan, serpihan).
- Sertakan kesilapan menaip, singkatan, emoji (untuk sembang), penukaran kod jika berkaitan.
- Tambah kes negatif yang kelihatan serupa tetapi sepatutnya tidak peta kepada niat ini.
3. Seimbangkan kelas anda
Latihan yang sangat berat sebelah (contohnya, 500 contoh untuk satu niat dan 10 untuk yang lain) menjejaskan kualiti ramalan. Kekalkan saiz niat yang agak sekata dan kembangkannya bersama-sama mengikut arahan trafik.
4. Sahkan kualiti sebelum latihan
Sekat data isyarat rendah dengan pengesah semasa pengarangan/pengumpulan:
- Pengesanan bahasa: memastikan contoh adalah dalam bahasa sasaran.
- Pengesan omong kosong: tangkap rentetan yang mengarut.
- Pemeriksaan pendua/hampir pendua: kekalkan kepelbagaian tinggi.
- Regex/ejaan & tatabahasa: menguatkuasakan peraturan gaya jika perlu.
Pengesah pintar (seperti yang digunakan oleh Appen) boleh mengautomasikan sebahagian besar penjaga pintu ini.
5. Labelkan entiti secara konsisten
Takrifkan jenis slot (tarikh, produk, alamat) dan tunjukkan anotator cara menandakan sempadan . Corak seperti Pattern any dalam LUIS boleh menjelaskan rentang yang panjang dan berubah-ubah (cth., nama dokumen) yang mengelirukan model.
6. Uji seperti pengeluaran
Tolak ujaran sebenar yang tidak kelihatan ke titik akhir ramalan atau bot pementasan, semak salah klasifikasi dan promosikan contoh samar-samar ke dalam latihan. Jadikan ini satu gelung: kumpul → latih → semak → kembangkan.
Maksud "realiti tidak kemas" sebenarnya (dan cara mengendalikannya)
Pengguna sebenar jarang bercakap dalam ayat yang sempurna. Jangkakan:
- Serpihan: “bayaran balik yuran penghantaran”
- Matlamat kompaun: “batalkan pesanan dan susun semula dengan warna biru”
- Entiti tersirat: "hantar ke pejabat saya" (anda mesti tahu pejabat mana)
- Kekaburan: “ubah rancangan saya” (pelan mana? berkuat kuasa bila?)
Pembetulan praktikal
- Menyediakan gesaan yang menjelaskan hanya apabila diperlukan; elakkan terlebih bertanya.
- Tangkap pemindahan konteks (kata ganti nama seperti "perintah itu," "yang terakhir").
- Penggunaan niat mundur dengan pemulihan yang disasarkan: "Saya boleh membantu membatalkan atau menukar rancangan-apa yang anda mahukan?"
- Pantau kesihatan niat (kekeliruan, perlanggaran) dan tambah data di mana ia lemah
Pembantu suara dan kata bangun: data berbeza, peraturan serupa
Bila (dan cara) menggunakan data luar biasa berbanding data tersuai
- Di luar rak: liputan lompat mula di tempat baharu, kemudian ukur tempat kekal kekeliruan.
- Adat: tangkap bahasa domain anda (istilah dasar, nama produk) dan "suara jenama."
- Dicampur: mulakan secara meluas, kemudian tambahkan data berketepatan tinggi untuk niat dengan kesan pesongan atau hasil yang paling banyak.
Jika anda memerlukan program on-ramp yang pantas, Shaip menyediakan pengumpulan ujaran dan set data pertuturan/sembang sedia ada merentasi pelbagai bahasa; lihat kajian kes untuk pelancaran pembantu berbilang bahasa.
Senarai semak pelaksanaan
- Tentukan niat dan entiti dengan contoh dan negatif kes
- Pengarang pelbagai, seimbang lafaz untuk setiap niat (mula kecil, berkembang setiap minggu)
- Tambah pengesah (bahasa, omong kosong, pendua, regex) sebelum latihan
- Menubuhkan gelung ulasan daripada lalu lintas sebenar; mempromosikan item yang tidak jelas kepada latihan
- Track kesihatan niat dan perlanggaran; betulkan dengan lafaz baru
- Nilai semula mengikut saluran/tempatan untuk menangkap drift lebih awal
Bagaimana Shaip boleh membantu
- Pengumpulan & pelabelan sebutan tersuai (sembang + suara) dengan pengesah untuk memastikan kualiti tinggi.
- Set data sedia untuk digunakan merentas 150+ bahasa/varian untuk bootstrap pantas.
- Program semakan yang sedang dijalankan yang menukar trafik langsung kepada data latihan isyarat tinggi—selamat (kawalan PII).