
-
-
-
Mengikut Industri
-
Mengikut Kes Penggunaan
-
-
Syarikat

Untuk beberapa ketika, terdapat perbincangan tentang bagaimana Kecerdasan Buatan (AI) akan mengubah setiap aspek kehidupan manusia, dan kini anda pasti telah menyedari bahawa ia berpotensi menjadi teknologi paling disruptif yang pernah ada. Hari ini kita boleh bercakap dengan Siri, Cortana atau Google untuk menyelesaikan pertanyaan asas kita, tetapi sebahagian besar potensi sebenar mereka masih belum diketahui.
Membina AI yang benar-benar memahami bahasa manusia memerlukan lebih daripada sekadar data mentah — ia memerlukan set data latihan pakar linguistik yang dilabel tepat dan disampaikan pada skala perusahaan. Shaip ialah penyedia perkhidmatan NLP terkemuka yang menawarkan perkhidmatan dan penyelesaian pemprosesan bahasa semula jadi hujung ke hujung untuk pasukan AI di seluruh dunia: daripada pengumpulan data teks dan audio tersuai kepada anotasi pakar, set data NLP sedia ada dan penyampaian tenaga kerja yang diuruskan sepenuhnya merentasi 150+ bahasa.
Sama ada anda melatih sistem AI perbualan, memperhalusi model bahasa besar (LLM), membina enjin analisis sentimen atau menskala saluran paip pengecaman entiti bernama (NER) — lebih 30 ribu kolaborator Shaip yang bertauliah memberikan data latihan NLP berstruktur dan berkualiti tinggi yang diperlukan oleh model anda untuk berfungsi dengan tepat di dunia nyata. Dipercayai oleh syarikat Fortune 500 merentasi penjagaan kesihatan, kewangan, teknologi dan peruncitan, penyelesaian NLP Shaip menggabungkan perkakasan platform proprietari, proses kualiti 6 Sigma dan pakar domain untuk memenuhi keperluan ketepatan dan daya pemprosesan AI gred pengeluaran.

Setiap model bahasa berprestasi tinggi bermula dengan data latihan khusus domain yang dibina khas. Perkhidmatan pengumpulan data NLP Shaip mendapatkan input tepat yang diperlukan oleh model anda — pada jumlah yang banyak, dalam bahasa anda dan dengan kepelbagaian linguistik yang diperlukan oleh penggunaan dunia sebenar.
Kami mendapatkan korpora teks tersuai dalam volum besar merentasi format: e-mel, ulasan pelanggan, siaran media sosial, tiket sokongan, kontrak undang-undang, dokumen kewangan dan banyak lagi. Tersedia dalam 150+ bahasa dan dialek serantau, perkhidmatan pengumpulan teks kami memperkasakan latihan chatbot, penalaan halus LLM, sistem kerelevanan carian dan saluran pemahaman dokumen.
Daripada gesaan skrip kepada dialog perbualan spontan, Shaip mengumpul rakaman audio berkualiti tinggi yang disesuaikan dengan keperluan ASR atau AI suara anda — termasuk aksen khusus, persekitaran hingar, demografi penutur dan keadaan saluran. Dihantar sebagai koleksi kendiri atau sebagai pakej ASR lengkap dengan transkripsi, leksikon sebutan dan dokumentasi khusus bahasa untuk latihan model segera. Semua data yang dikumpul dihantar dengan metadata penuh, atribusi penutur dan pengesahan kualiti melalui platform anotasi proprietari Shaip.
Model NLP yang tepat memerlukan data latihan yang diberi anotasi dengan tepat. Perkhidmatan anotasi data Shaip menggabungkan tenaga kerja berbilang bahasa yang bertauliah dengan platform proprietari untuk menyampaikan label yang tepat secara konsisten pada skala perusahaan — dengan pintu kualiti terbina dalam dan penjejakan penghantaran yang telus.

Keupayaan anotasi NLP kami merangkumi setiap jenis tugas utama:
Semua anotasi disampaikan melalui proses kualiti pintu peringkat 6 Sigma dengan pemarkahan persetujuan antara anotasi dan gelung maklum balas berterusan.

Layari set data audio kami yang terdiri daripada pelbagai set data NLP sedia ada, yang terdiri daripada lebih 20,000 jam audio, mengenai pelbagai topik seperti Pusat Panggilan, Perbualan Umum, Debat, Ucapan, Ceramah, Dokumentari, Acara, Perbualan Umum, Filem, Berita dll., dalam lebih 40 bahasa.
Kami menawarkan sumber mahir yang menjadi lanjutan pasukan anda untuk menyokong tugasan anotasi data anda, melalui alatan yang anda sukai sambil mengekalkan kualiti yang diingini. Tenaga kerja kami yang berpengalaman memahami selok-belok bahasa manusia dan mengaplikasikan amalan terbaik yang dipelajari dengan melabel berjuta-juta dokumen audio & teks untuk memberikan penyelesaian pelabelan data bertaraf dunia untuk pemprosesan bahasa semula jadi.

Daripada pengumpulan teks/audio hingga anotasi, kami membawakan pemahaman yang lebih mendalam tentang dunia pertuturan dengan teks dan audio yang terperinci dan dilabelkan dengan tepat untuk meningkatkan prestasi model NLP anda. Sama ada anda melatih pembantu maya/digital, ingin menyemak kontrak undang-undang atau membina algoritma analisis kewangan, kami menyediakan data standard emas yang anda perlukan untuk menjadikan model anda berfungsi di dunia nyata. Pasukan kami memahami bahasa, dialek, sintaks & struktur ayat untuk menanda teks dengan tepat, berdasarkan keperluan perniagaan anda.
Kami merupakan antara segelintir syarikat NLP yang berbangga dengan kebolehan linguistik mereka yang kukuh. Kami mempunyai tenaga kerja global yang terdiri daripada lebih 30,000 kolaborator dari seluruh dunia, yang mempunyai kepakaran dalam lebih 150 bahasa . Kami telah membantu syarikat baharu peringkat awal, perusahaan kecil & sederhana, dan bekerjasama dengan syarikat Fortune 500 teratas merentasi pelbagai vertikal seperti penjagaan kesihatan, runcit/e-dagang, kewangan, teknologi dan banyak lagi untuk mencapai matlamat projek NLP mereka.
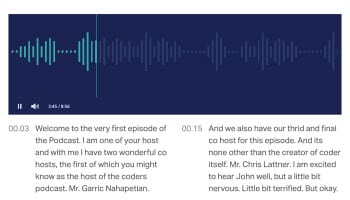
Lebih 50k jam set data audio/pertuturan di luar rak untuk membantu anda.
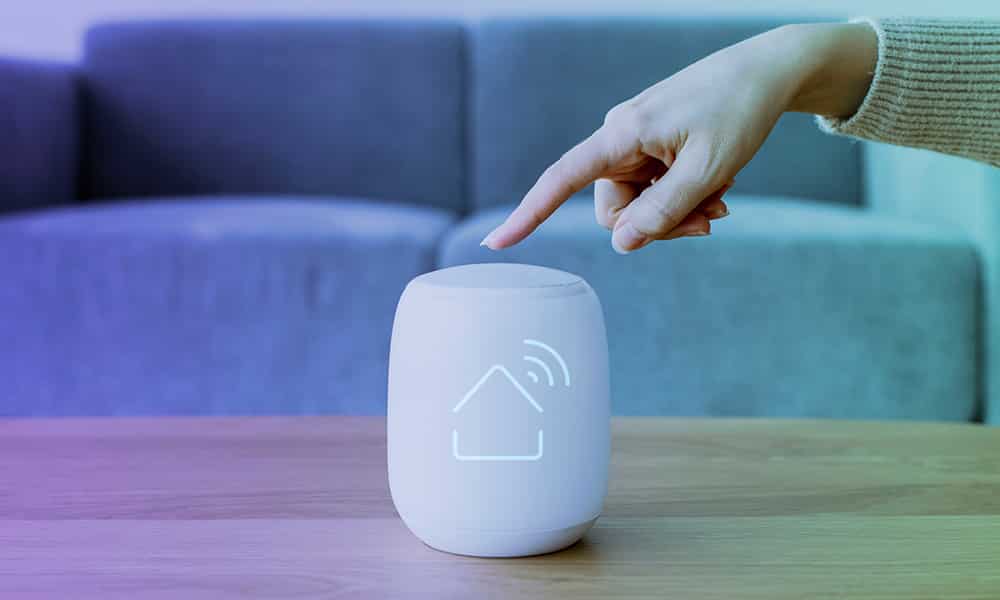
Analisis emosi manusia dengan mentafsir nuansa dalam ulasan pelanggan, media sosial, dll.

Kumpul set data teks iaitu, e-mel, SMS, blog, dokumen, kertas penyelidikan dll.

Melatih pembantu digital memerlukan sebilangan besar data berkualiti dari pelbagai geografi, bahasa, dialek, susunan, dan format. Di Shaip, kami menawarkan data latihan untuk Model AI dengan Human-in-the-loop yang mempunyai pengetahuan yang diperlukan, kepakaran domain, dan mengetahui keperluan khusus pelanggan.
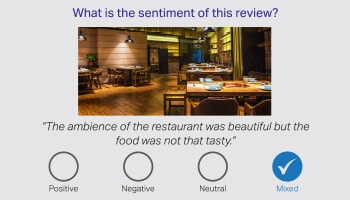
Benar dikatakan, bahawa kata-kata sahaja gagal menyampaikan keseluruhan cerita, dan tanggungjawab terletak pada anotator manusia untuk menafsirkan kekaburan dalam bahasa manusia. Oleh itu, mengenal pasti Sentimen pelanggan, berdasarkan perbualan adalah sangat penting. Pakar bahasa kami dari pelbagai domain dapat menafsirkan nuansa dalam ulasan produk, berita kewangan, dan media sosial.
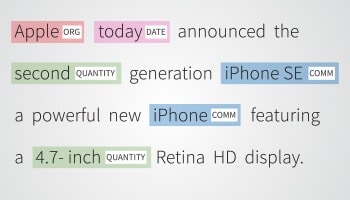
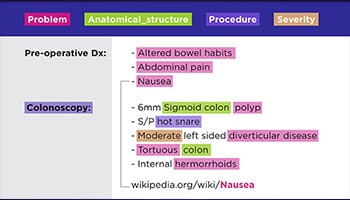
Named Entity Recognition (NER) adalah mengenal pasti, mengekstrak, dan mengklasifikasikan entiti yang dinamakan dalam teks, ke dalam kategori yang telah ditentukan. Teks tersebut dapat dikategorikan sebagai tempat, nama, organisasi, produk, kuantiti, nilai, peratusan, dan lain-lain. Dengan NER, Anda dapat menjawab pertanyaan di dunia nyata seperti organisasi mana yang disebutkan dalam artikel itu dll.
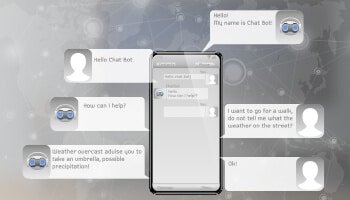
Virtual Chatbots atau Pembantu Digital yang kuat dan terlatih telah merevolusikan cara pelanggan berkomunikasi dengan penjual menambah peningkatan pengalaman pelanggan yang ketara.
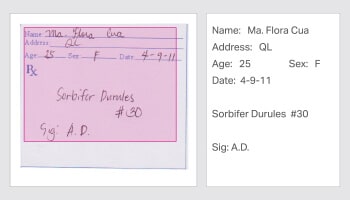
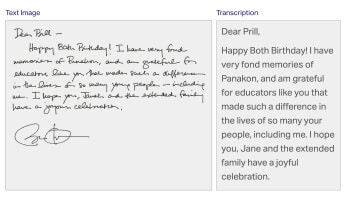
Dari preskripsi tulisan tangan doktor hingga nota panggilan persidangan, pakar kami dapat mendigitalkan sebarang bentuk data seperti, dokumen yang diarkibkan, kontrak undang-undang, rekod kesihatan pesakit, dll.
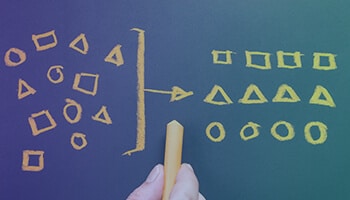
Pengkategorian yang juga dikenali sebagai klasifikasi atau penandaan adalah proses mengklasifikasikan teks ke dalam kumpulan teratur dan melabelnya, berdasarkan ciri-ciri minatnya.
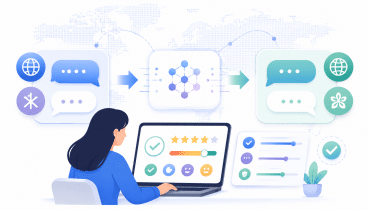
Penilaian manusia dan penyuntingan pasca output terjemahan mesin untuk mengukur kefasihan, kecukupan dan ketepatan domain — membolehkan sistem MT yang andal untuk penggunaan berbilang bahasa.
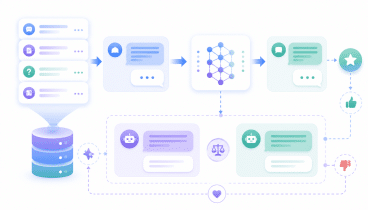
Set data ikut arahan yang dipilih susun, pasangan gesaan-respons dan data keutamaan RLHF untuk menyelaraskan dan menyelaraskan model bahasa besar dengan keperluan domain, nada dan tugas anda.
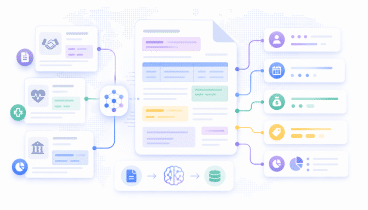
Anotasi struktur dokumen yang kompleks — kontrak, rekod perubatan, pemfailan kewangan — untuk melatih model AI dokumen yang mengekstrak, mengklasifikasikan dan menaakul berdasarkan teks tidak berstruktur pada skala besar.
Analisis Topik atau pelabelan topik adalah mengenal pasti dan mengekstrak makna dari teks yang diberikan dengan mengenal pasti topik / tema berulang yang sedang dipertimbangkan.
Transkripsikan ucapan / podcast / seminar, panggil perbualan ke dalam teks. Manfaatkan manusia untuk memberi anotasi fail audio / pertuturan dengan tepat untuk melatih model NLP dengan tepat.

Kategorikan bunyi atau ujaran untuk mengklasifikasikan pertuturan / audio berdasarkan bahasa, dialek, semantik, leksikon, dll.
Kumpulan pakar kami yang mahir dalam teks/anotasi audio/pelabelan boleh mendapatkan set data NLP beranotasi yang tepat & berkesan.
Pasukan kami membantu anda menyediakan data teks / audio untuk melatih mesin AI, menjimatkan masa & sumber yang berharga.
Pasukan kolaborator kami dapat menampung jumlah tambahan sambil mengekalkan kualiti output data untuk Penyelesaian NLP anda.
Sebagai pakar dalam melatih dan mengurus pasukan, kami memastikan projek diserahkan dalam anggaran yang ditentukan.
Pasukan ini menganalisis data dari pelbagai sumber & mampu menghasilkan data latihan AI dengan cekap dan banyak di semua industri.
Kumpulan data audio / teks yang luas menyediakan AI dengan banyak maklumat yang diperlukan untuk melatih lebih cepat.

Pasukan yang berdedikasi dan terlatih:

Kecekapan proses tertinggi dijamin dengan:

Platform yang dipatenkan menawarkan faedah:
Chatbot AI menyediakan pengalaman pengguna yang dipertingkatkan dengan belajar daripada interaksi sebelumnya, memahami tingkah laku pengguna & memahami bahasa yang berbeza menggunakan kemahiran membuat keputusan lanjutan.

Pengecaman pertuturan automatik (ASR) telah berjalan jauh. Walaupun ia dicipta lama dahulu, ia hampir tidak pernah digunakan oleh sesiapa pun. Walau bagaimanapun, masa dan teknologi kini telah berubah dengan ketara.

Pasaran pemprosesan bahasa semula jadi global dijangka meningkat daripada $1.8 bilion pada 2021 kepada $4.3 bilion pada 2026, berkembang pada CAGR sebanyak 19.0% dalam tempoh tersebut.
Memperkasakan pasukan untuk membina produk AI yang terkemuka di dunia.


NLP ialah cabang kecerdasan buatan yang membolehkan mesin memahami, menganalisis dan bertindak balas terhadap bahasa manusia, kedua-dua teks dan pertuturan, dengan mentafsir konteks, sentimen dan niat.
NLP melibatkan pemprosesan bahasa manusia menggunakan algoritma yang menganalisis tatabahasa, sintaks, semantik dan konteks. Ia bergantung pada volum besar data beranotasi untuk melatih model AI untuk mengekstrak makna, mengenal pasti corak dan menjana respons yang tepat.
NLP digunakan dalam aplikasi seperti pembantu maya, chatbots, analisis sentimen, terjemahan mesin, ringkasan teks, pengesanan spam dan pembetulan tatabahasa. Ia menguatkan sistem yang menjadikan interaksi manusia-komputer lebih cekap dan semula jadi.
Perkhidmatan NLP termasuk pengumpulan teks (menyumber data teks yang pelbagai), pengumpulan audio (data pertuturan merekodkan), anotasi data (teks pelabelan dan audio untuk latihan AI), dan transkripsi (menukar pertuturan kepada teks untuk analisis).
Penyelesaian NLP meningkatkan model AI dengan menyediakan set data berlabel tepat yang membantu model memahami bahasa manusia dengan lebih baik. Ini meningkatkan tugas seperti analisis sentimen, pengecaman entiti yang dinamakan (NER), AI perbualan dan latihan chatbot.
Industri utama termasuk penjagaan kesihatan (menganalisis rekod perubatan dan sentimen pesakit), kewangan (pengesanan penipuan dan analisis dokumen), dan e-dagang (syor diperibadikan dan automasi sokongan pelanggan).
Garis masa berbeza-beza berdasarkan saiz dan kerumitan projek tetapi dioptimumkan untuk menyampaikan data berkualiti tinggi dengan cekap.
Kualiti dijamin melalui proses pengesahan yang ketat, pencatat pakar dan alat lanjutan, memastikan data memenuhi piawaian tertinggi.
Kos bergantung pada faktor seperti skop projek, kerumitan data dan keperluan penyesuaian. Hubungi Shaip untuk sebut harga yang diperibadikan berdasarkan keperluan anda.
NLP sebagai perkhidmatan merujuk kepada model penyampaian data yang diuruskan sepenuhnya di mana penyedia perkhidmatan NLP mengendalikan setiap peringkat saluran data bahasa anda — pengumpulan, anotasi, jaminan kualiti dan penyampaian — bagi pihak anda. Shaip menawarkan model penyampaian pasukan berasaskan projek, langganan dan terbenam untuk memenuhi keperluan organisasi dan skala projek yang berbeza.
Setiap kumpulan bahasa terdiri daripada penutur asli atau hampir asli yang direkrut dan ditapis untuk pengetahuan domain. Anotasi dikalibrasi berdasarkan set rujukan standard emas dan proses kualiti peringkat 6 Sigma dengan pemarkahan persetujuan antara anotasi memastikan konsistensi merentasi semua pasangan bahasa dan dialek.
Shaip mengendalikan aliran kerja yang peka HIPAA untuk projek NLP penjagaan kesihatan dan selaras dengan keperluan pengurusan persetujuan GDPR untuk pengumpulan data EU. Semua projek termasuk dokumentasi jejak audit, rekod asal data dan kawalan akses berasaskan peranan untuk pasukan pematuhan perusahaan.
Ya. Shaip menyediakan set data mengikut arahan, pasangan gesaan-respons dan data keutamaan RLHF untuk penalaan halus dan penjajaran LLM. Halaman penyelesaian Generatif AI kami merangkumi skop penuh perkhidmatan data latihan LLM.
Pengumpulan data melibatkan penyumberan teks atau audio mentah — bahan input yang akan dipelajari oleh model anda. Anotasi melibatkan pelabelan data mentah tersebut dengan tag berstruktur, kategori, entiti atau penunjuk sentimen yang memberitahu model apa yang perlu difahami. Shaip menawarkan kedua-duanya sebagai perkhidmatan kendiri atau sebagai penyelesaian data NLP hujung ke hujung bersepadu.
Ya. Shaip telah bekerjasama dengan syarikat permulaan peringkat awal, PKS dan perusahaan Fortune 500. Kami menawarkan skop projek yang fleksibel, pakej set data minimum yang berdaya maju untuk AI peringkat MVP dan model penyampaian berskala yang berkembang mengikut keperluan anotasi anda. Hubungi kami untuk sebut harga tersuai.

Kami menggunakan kuki untuk meningkatkan pengalaman anda di tapak kami. Dengan menggunakan tapak kami, anda bersetuju dengan kuki.
Urus pilihan kuki anda di bawah:
Kuki penting membolehkan fungsi asas dan diperlukan untuk fungsi laman web yang betul.
Pengurus Tag Google memudahkan pengurusan tag pemasaran di laman web anda tanpa perubahan kod.
Kuki statistik mengumpul maklumat tanpa nama. Maklumat ini membantu kami memahami cara pelawat menggunakan tapak web kami.
Google Analitis ialah alat berkuasa yang menjejak dan menganalisis trafik tapak web untuk keputusan pemasaran termaklum.
URL Perkhidmatan: policies.google.com (dibuka dalam tetingkap baharu)
Kuki pemasaran digunakan untuk mengikuti pelawat ke tapak web. Tujuannya adalah untuk memaparkan iklan yang relevan dan menarik kepada pengguna individu.
Google Ads ialah platform pengiklanan dalam talian yang membolehkan perniagaan mencipta iklan yang disasarkan yang dipaparkan pada hasil carian Google dan tapak rakan kongsi.
URL Perkhidmatan: policies.google.com (dibuka dalam tetingkap baharu)
HubSpot ialah platform pemasaran, jualan dan khidmat pelanggan semua-dalam-satu yang memperkemas pertumbuhan perniagaan.
URL Perkhidmatan: legal.hubspot.com (dibuka dalam tetingkap baharu)
Anda boleh mendapatkan maklumat lanjut dalam Dasar Kuki dan Dasar Privasi kami.