Bina aplikasi suara yang sentiasa mendengar dengan data latihan perkataan bangun tersuai. Ketepatan pengesanan yang lebih tinggi, kurang pengaktifan palsu.
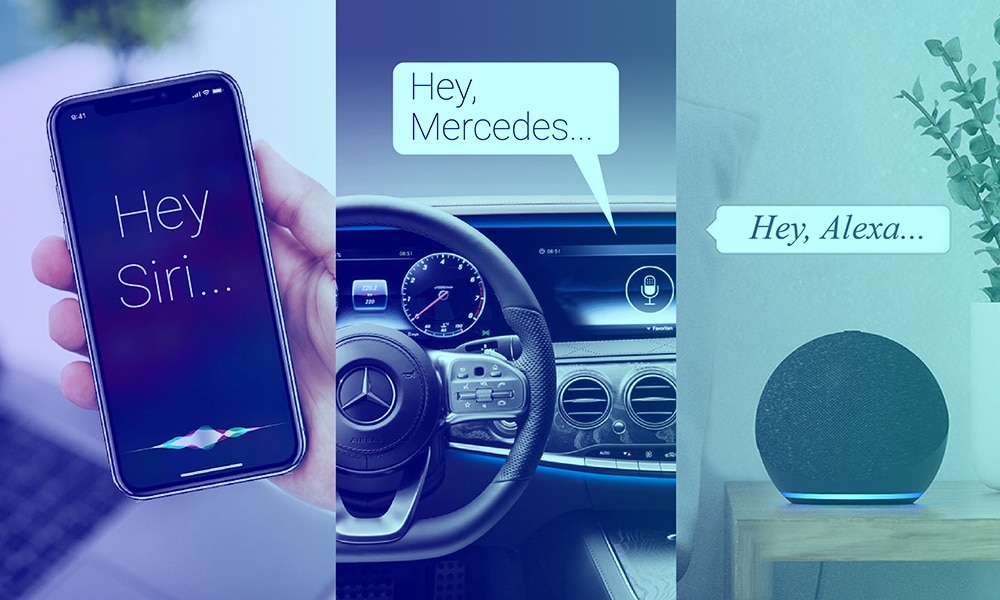
Pembantu suara telah mengubah secara mendadak cara pelanggan berinteraksi dengan peranti mereka. Mereka telah memudahkan pengguna untuk meneroka produk dan perkhidmatan – dengan cepat dan cekap. Walau bagaimanapun, adakah aplikasi suara itu mendengar? Untuk meletakkan aplikasi ini dalam pemacu tinggi, ia perlu dibangunkan dan beralih daripada mendengar pasif kepada aktif dengan bantuan WAKE WORDS. 'Alexa' dan "Hey Siri' ialah dua daripada perkataan bangun yang paling popular di dunia.
Menjelang 2024, bilangan pembantu suara digital diramalkan mencecah 8.4 bilion unit – lebih banyak daripada populasi dunia.
Saiz pasaran aplikasi pembantu suara diramalkan akan meningkat daripada $2.8 bilion pada tahun 2021 kepada $11.2 bilion pada tahun 2026, pada CAGR sebanyak 32.4%.
Perkataan bangun ialah perkataan atau frasa tertentu seperti 'Hey Siri', 'Okay Google' dan 'Alexa'; direka untuk mengaktifkan peranti yang diaktifkan suara untuk bertindak balas apabila disebut. Walau bagaimanapun, perkataan bangun yang sentiasa didengar dan disepadukan secara setempat dengan peranti mengurangkan masa tindak balas secara drastik dan meningkatkan ketepatan pengenalpastian dan pemprosesan perkataan bangun walaupun tanpa sambungan internet. Shaip mengumpul data latihan perkataan bangun merentasi 100+ bahasa, pelbagai loghat, kumpulan umur dan persekitaran hingar dunia sebenar untuk memaksimumkan ketepatan pengesanan dan meminimumkan pengaktifan palsu. Ia juga dikenali sebagai:
Dengan tawaran latihan perkataan bangun yang sentiasa mendengar Shaip, model pembantu suara anda sentiasa ditala untuk mendengar perkataan bangun, tetapi tanpa benar-benar merakam atau menghantar data ke awan. Bekerjasama dengan Shaip memberi anda kelebihan bekerja dengan pakar. Dengan pengalaman luas kami menggunakan teknologi AI dan ML dalam membangunkan latihan pembantu suara, kami membantu anda menghapuskan risiko privasi, meningkatkan pengalaman pengguna, mengurangkan kos pembangunan dan meningkatkan kebolehskalaan.
Shaip membina data latihan untuk perkataan bangun berjenama sepenuhnya supaya pelanggan menyebut nama jenama anda — bukan pembantu generik. Setiap set data ditala kepada frasa pengaktifan tepat anda, mengukuhkan ingatan jenama dengan setiap interaksi dan mengekalkan pengalaman suara dalam ekosistem anda sendiri.
Shaip menyokong model perkataan bangun yang sentiasa mendengar yang berjalan pada peranti tanpa merakam atau menghantar audio ke awan. Data latihan perkataan bangun pada peranti mengurangkan kependaman, mengurangkan risiko privasi dan memastikan pengesanan berfungsi dengan andal walaupun tanpa sambungan internet.
Shaip mengumpul ujaran perkataan bangun merentasi 100+ bahasa dan loghat serantau — Scotland, Kanada, Australia, Bahasa Inggeris India dan seterusnya — jadi ketepatan pengesanan kekal merentasi pangkalan pengguna global dan bukannya menjejaskan penutur bukan asli.
Shaip merakam data perkataan bangun dalam keadaan senyap, bising, dalam kereta, luar dan medan jauh. Latihan tentang variasi akustik dunia sebenar mengurangkan penolakan palsu apabila pengguna bercakap dari jauh atau dalam hingar latar belakang.
Selain perkataan bangun, Shaip menyediakan data pengesanan ujaran dan frasa supaya peranti memproses arahan bahasa semula jadi yang lebih lama dengan kependaman rendah. Data pengesanan kata kunci terbenam menyokong pemprosesan pada pelayar dan pada cip untuk ketepatan dan privasi yang tinggi.
Fonem yang berbeza biasanya mencipta tandatangan yang lebih jelas dan memastikan ketepatan yang lebih baik dalam keputusan. Oleh itu, pilih frasa dalam data anda yang menghasilkan pelbagai bunyi.
Jadikan perkataan bangun lebih berkesan dengan melekatkannya dengan awalan seperti "Hai", "Hello," "Hei" atau "OK". Ia akan memastikan perkataan bangun tidak jelas & memastikan tiada padanan tidak sengaja berlaku apabila menggunakan perkataan pencetus dalam pertuturan biasa.
Jadikan kata bangun anda gabungan sekurang-kurangnya enam fonem yang mudah dilihat oleh mesin dan mudah disebut oleh manusia. Sebagai contoh, "Alexa" mempunyai enam fenomena manakala "Ok Google" mempunyai lapan fenomena.
Jangan membuat kesilapan menggunakan satu perkataan sebagai kata bangun anda. Perkataan bangun mestilah cukup panjang untuk dibezakan.
Pastikan perkataan pencetus yang anda cipta mestilah ringkas dan unik supaya mudah diingati.
Frasa bangun berbilang perkataan yang lebih panjang sukar untuk disebut dan menjadikan proses itu tidak semestinya lebih sukar.
Model kata bangun secara amnya dilatih untuk mengenali no. daripada lafaz yang berbeza, supaya ia boleh menjawab seruan yang berbeza. Walau bagaimanapun, mempunyai terlalu banyak perkataan bangun yang berbeza dengan mudah boleh mengaktifkan saluran pertuturan tanpa anda mengetahui sebutan mana yang dituturkan oleh pengguna.
Faktor seperti hingar, jarak dan variasi dalam aksen dan bahasa menjadikan pengesanan kata cepat yang tepat lebih sukar dan kompleks untuk model AI anda.
Pengalaman kami dalam teknologi suara membantu kami membangunkan perkataan bangun yang disesuaikan sentiasa mendengar dan frasa bangun berjenama dengan cepat. Dengan pengecaman suara seiring dengan pemahaman pemprosesan bahasa semula jadi, algoritma ML membantu menyalin pertuturan & melaksanakan arahan suara dengan berkesan.
Kami menumpukan pada membangunkan prototaip kata bangun dengan pantas untuk memastikan penyesuaian perkataan berjenama. Prototaip bertindak sebagai bukti konsep dan membantu dalam latihan yang tepat, masa yang lebih pantas untuk memasarkan, ujian dipercepatkan dan penghapusan risiko.
Alami pertumbuhan tanpa gangguan dan penglibatan pelanggan tanpa halangan dengan pembantu suara yang luar biasa. Kami menyediakan keupayaan pengecaman pertuturan berbilang bahasa supaya aplikasi dapat mengesan perkataan dan frasa dengan tepat walaupun dalam persekitaran hingar tinggi.
Ia merupakan satu cara untuk mengumpul data pengguna yang penting seperti identiti mereka, negara asal, umur, jantina, bahasa, aksen, dll. Kepelbagaian data digunakan untuk menambah baik algoritma berorientasikan pengguna untuk mencapai hasil yang lebih tepat.
Data biasanya cenderung menjana bias terbina dalam. Oleh itu, apabila kami mengumpul data daripada pelbagai sumber, berat sebelah dalam keputusan berkurangan dengan ketara.
Berikut ialah beberapa parameter kepelbagaian data yang Shaip alamat semasa membina kata bangun dan arahan perbualan lain.
| Bangsa dan Etnik | Hindu, Islam, Kristian, Afrikaans, Eropah |
| Tahap pendidikan | Sarjana Muda, Siswazah, Ph.D., Sarjana |
| Negara | China, Jepun, India, Korea, Dubai, Nigeria, Amerika Syarikat, Kanada |
| Seks | Laki-laki, Perempuan |
| Umur | Kurang daripada 10 tahun, 10-15, 15-25, 25-45, 45 tahun dan ke atas |
| Bahasa | Inggeris, Jepun, Turki, Cina, Thai, Hindi |
| alam Sekitar | Senyap, Bising, Muzik Latar Belakang, Bunyi/Ucapan Latar Belakang, Dalam Rumah, Luar Rumah, Teater, Stadium, Kafeteria, Dalam Kereta, Pejabat, Pusat Beli-belah, Bunyi Rumah, Tangga, Jalan/Jalan Raya, Tepi Laut (Berangin) |
| Aksen (Bahasa Inggeris) | Bahasa Inggeris Scotland, Bahasa Inggeris Wales, Bahasa Inggeris Hiberno-Inggeris, Bahasa Inggeris Kanada, Bahasa Inggeris Australia, Bahasa Inggeris New Zealand |
| Gaya Bertutur | Kelajuan pantas/normal/perlahan, kelantangan tinggi/normal/lembut, formal/kasual |
| Kedudukan Peranti | Pegang tangan, Desktop |
Data perkataan bangun untuk pembesar suara, TV dan peralatan yang mesti diaktifkan serta-merta dan menolak perbualan latar belakang.
Set data perkataan bangun medan jauh yang teguh hingar untuk pembantu dalam kabin bebas tangan.
Data perkataan bangun jejak rendah untuk peranti yang sentiasa hidup dan kekangan bateri.
Data perkataan dan ujaran bangun tersuai untuk menyetempatkan pembantu merentasi bahasa dan dialek.
Data perkataan bangun pada peranti yang mengutamakan privasi untuk tetapan klinikal dan pesakit bebas tangan.
Data perkataan bangun dan arahan berbilang modal untuk robot yang bertindak balas dalam masa nyata tanpa awan.
Shaip bekerjasama dengan anda untuk memilih perkataan bangun yang berbeza secara fonetik dan sejajar dengan jenama serta mentakrifkan garis panduan pengumpulan.
Tenaga kerja global Shaip merekodkan perkataan bangun merentasi bahasa, loghat, umur, peranti dan persekitaran hingar yang diperlukan.
Setiap ujaran ditranskripsikan, dilabelkan dan disemak kualitinya berdasarkan kriteria penerimaan anda.
Shaip menyediakan data latihan perkataan bangun yang berstruktur dan dikawal dasar yang diformat untuk saluran paip model anda.
Untuk melaksanakan inisiatif AI anda dengan berkesan, anda memerlukan banyak kumpulan data latihan khusus. Shaip adalah salah satu daripada sedikit syarikat di pasaran yang memastikan data latihan yang boleh dipercayai bertaraf dunia pada skala yang mematuhi syarat peraturan / GDPR.
Buat, pilih, dan kumpulkan set data yang dibuat khas (teks, ucapan, gambar, video) dari 100+ negara di seluruh dunia berdasarkan panduan tersuai.
Manfaatkan tenaga kerja global kami yang terdiri daripada 30,000+ penyumbang berpengalaman & bertauliah. Tugasan tugas yang fleksibel & kapasiti, kecekapan & pemantauan kemajuan tenaga kerja masa nyata.
Platform proprietari & tenaga kerja mahir kami menggunakan pelbagai kaedah kawalan kualiti untuk memenuhi atau melebihi standard kualiti yang ditetapkan untuk mengumpulkan set data latihan AI.
Proses kami menyelaraskan, proses pengumpulan melalui pengagihan tugas, pengurusan, & penangkapan data yang lebih mudah secara langsung dari antara muka aplikasi & web.
Jaga kerahsiaan data lengkap dengan menjadikan privasi sebagai keutamaan kami. Kami memastikan format data dikawal dan dipelihara oleh dasar.
Data khusus domain yang disusun dikumpulkan dari sumber khusus industri berdasarkan garis panduan pengumpulan data pelanggan.
Shaip menawarkan perkhidmatan pengumpulan data pertuturan/audio hujung ke hujung dalam lebih 150+ bahasa untuk membolehkan teknologi yang didayakan suara memenuhi kumpulan khalayak yang pelbagai di seluruh dunia.
Chatbot yang anda berbual berjalan pada sistem AI perbualan lanjutan yang dilatih, diuji & dibina menggunakan banyak set data pengecaman pertuturan. Ia adalah proses asas di sebalik teknologi yang menjadikan mesin pintar
Keperluan untuk latihan Utterance timbul kerana tidak semua pelanggan menggunakan perkataan atau frasa yang tepat semasa berinteraksi atau bertanya soalan kepada pembantu suara mereka dalam format skrip.
Memperkasakan pasukan untuk membina produk AI yang terkemuka di dunia.
Perkataan bangun ialah perkataan atau frasa tertentu — seperti "Alexa," "Okay Google," atau frasa berjenama tersuai — yang mengaktifkan peranti yang didayakan suara dan menukarnya daripada pendengaran pasif kepada pendengaran aktif. Peranti ini sentiasa mendengar perkataan bangun secara setempat dan hanya mula memproses permintaan sebaik sahaja perkataan bangun dikesan.
Data latihan perkataan bangun ialah set rakaman lisan berlabel yang digunakan untuk mengajar model mengecam frasa pengaktifannya. Data latihan perkataan bangun yang berkesan merangkumi pelbagai penutur, loghat, umur, peranti dan keadaan hingar supaya model boleh mencetuskan dengan andal sambil menolak pertuturan yang berbunyi serupa.
Perkataan bangun berfungsi dengan menjalankan model pengesanan kecil yang sentiasa didengar yang mengimbas audio masuk untuk frasa sasaran. Apabila model memadankan perkataan bangun dengan keyakinan yang mencukupi, peranti akan diaktifkan dan mula memproses permintaan pengguna menggunakan pengecaman pertuturan dan pemprosesan bahasa semula jadi.
Kata bangun tersuai yang kuat menggunakan fonem yang pelbagai, mengandungi sekurang-kurangnya tiga hingga empat suku kata dan mengelakkan perkataan seharian yang biasa digunakan untuk mengurangkan pengaktifan palsu. Menambah awalan seperti "Hei" atau "OK" meningkatkan kekhususan. Shaip membantu memilih dan mengesahkan perkataan bangun semasa persediaan projek.
Ya. Pengesanan perkataan bangun pada peranti menjalankan model pengaktifan secara setempat, jadi audio tidak dirakam atau dihantar ke awan. Ini mengurangkan kependaman, melindungi privasi dan memastikan pengesanan berfungsi di luar talian. Shaip mengumpul data latihan yang khusus disesuaikan untuk penggunaan pada peranti dan terbenam.
Shaip mengumpul data latihan perkataan bangun dalam lebih 100 bahasa dan pelbagai loghat serantau, yang diperoleh daripada tenaga kerja global merentasi lebih 100 negara. Keluasan ini mengurangkan jurang ketepatan untuk penutur bukan asli dan menyokong pelancaran produk global.
Shaip menggunakan pelbagai pas kawalan kualiti — semakan transkripsi, kriteria penerimaan dan pemantauan tenaga kerja — supaya set data memenuhi ketepatan sasaran sebelum penghantaran. Data yang pelbagai dan berkualiti tinggi mengurangkan kadar penerimaan palsu dan penolakan palsu dalam model yang digunakan.
Perkataan bangun mengaktifkan peranti; ujaran ialah permintaan lisan yang menyusul. Pengesanan perkataan bangun ialah tugas sentiasa aktif yang sempit, manakala pemahaman ujaran melibatkan pentafsiran pelbagai frasa bahasa semula jadi. Shaip menyediakan data latihan untuk pengesanan perkataan bangun dan pengumpulan ujaran.
Ujaran ialah frasa yang dituturkan oleh pengguna untuk membuat permintaan kepada perisian arahan suara. Perisian tersebut mengenal pasti niat pengguna daripada ujaran tersebut dan memberi respons sewajarnya. Tidak seperti ayat yang lengkap, ujaran ialah unit pertuturan yang mungkin tidak menyampaikan pemikiran penuh dan selalunya mengandungi jeda. Contoh: “Tunjukkan saya filem terbaharu — yang dikeluarkan minggu lepas,” atau “Adakah kedai di 22nd Street dibuka sekarang?”
Nama panggilan ialah kata kunci yang digunakan untuk mencetuskan "kemahiran" tertentu dalam perisian suara. Ia boleh merangkumi nama orang atau tempat dan digabungkan dengan tindakan, arahan atau soalan. Setiap kemahiran tersuai memerlukan nama panggilan untuk memulakannya.
Kata-kata pembangkit juga dipanggil kata pencetus, kata-kata panas, kata-kata pengaktifan, kata-kata seruan, frasa pembangkit dan ujaran.
Alexa menggunakan beberapa mikrofon terbina dalam untuk mengesan perkataan bangunnya sambil menapis hingar latar belakang. Untuk mengelakkan positif dan negatif palsu, ia hanya mula mendengar secara aktif selepas mengesan "Alexa".
Kami menggunakan kuki untuk meningkatkan pengalaman anda di tapak kami. Dengan menggunakan tapak kami, anda bersetuju dengan kuki.
Urus pilihan kuki anda di bawah:
Kuki penting membolehkan fungsi asas dan diperlukan untuk fungsi laman web yang betul.
Pengurus Tag Google memudahkan pengurusan tag pemasaran di laman web anda tanpa perubahan kod.
Kuki statistik mengumpul maklumat tanpa nama. Maklumat ini membantu kami memahami cara pelawat menggunakan tapak web kami.
Google Analitis ialah alat berkuasa yang menjejak dan menganalisis trafik tapak web untuk keputusan pemasaran termaklum.
URL Perkhidmatan: policies.google.com (dibuka dalam tetingkap baharu)
Kuki pemasaran digunakan untuk mengikuti pelawat ke tapak web. Tujuannya adalah untuk memaparkan iklan yang relevan dan menarik kepada pengguna individu.
Google Ads ialah platform pengiklanan dalam talian yang membolehkan perniagaan mencipta iklan yang disasarkan yang dipaparkan pada hasil carian Google dan tapak rakan kongsi.
URL Perkhidmatan: policies.google.com (dibuka dalam tetingkap baharu)
HubSpot ialah platform pemasaran, jualan dan khidmat pelanggan semua-dalam-satu yang memperkemas pertumbuhan perniagaan.
URL Perkhidmatan: legal.hubspot.com (dibuka dalam tetingkap baharu)
Anda boleh mendapatkan maklumat lanjut dalam Dasar Kuki dan Dasar Privasi kami.