
Perkhidmatan Data Latihan AI untuk Pembelajaran Mesin & AI Generatif
Shaip ialah penyedia data latihan AI terkemuka yang membantu pasukan AI dan pembelajaran mesin membina model yang tepat, tidak berat sebelah dan sedia untuk pengeluaran — daripada pengumpulan dan anotasi data kepada penalaan halus LLM dan penilaian model, merentasi 65+ bahasa dan 60+ negara.
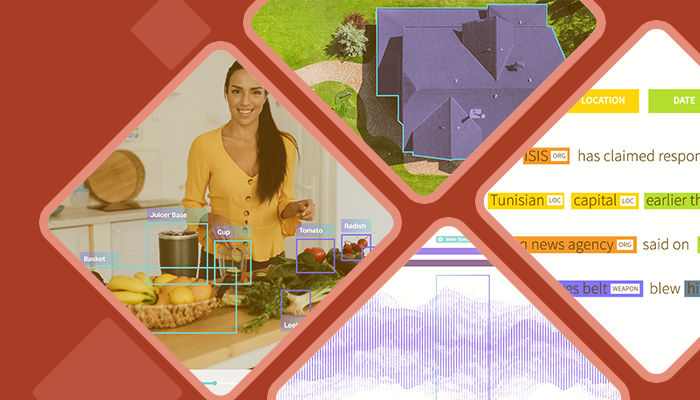
Asas Setiap Model AI
Apakah Data Latihan AI?
Data latihan AI ialah maklumat berlabel atau berstruktur yang digunakan untuk mengajar model pembelajaran mesin cara mengenali corak dan membuat ramalan. Kualiti, kepelbagaian dan ketepatan data ini secara langsung menentukan prestasi model dalam dunia sebenar.
Data latihan AI yang berkualiti tinggi mewakili penggunaan dunia sebenar, dilabelkan dengan tepat, diseimbangkan untuk mengurangkan bias dan mematuhi peraturan privasi data. Data yang berkualiti rendah merupakan punca utama ramalan yang tidak tepat, halusinasi model dan kitaran latihan semula yang mahal — itulah sebabnya pasukan AI terkemuka bekerjasama dengan syarikat data latihan AI pakar seperti Shaip dan bukannya bergantung pada pelabelan dalaman ad-hoc.
Perkhidmatan Data AI hujung ke hujung
Perkhidmatan Data Latihan AI Kami
Semua yang anda perlukan merentasi kitaran hayat model penuh — daripada mendapatkan data mentah hinggalah penalaan halus dan menilai model anda.
Perkhidmatan Pengumpulan Data
Set data audio, pertuturan, imej, video dan teks tersuai — data dunia sebenar yang dipersetujui sepenuhnya yang dikumpulkan merentasi 60+ negara dan 65+ bahasa, supaya model anda belajar daripada pelbagai contoh yang representatif.
→ Ketahui lebih lanjutAnotasi & Pelabelan Data
Pelabelan sempurna piksel oleh anotator dan pakar domain terlatih — kotak sempadan, segmentasi, NER, penandaan sentimen dan niat serta transkripsi — disahkan melalui QA berbilang peringkat.
→ Ketahui lebih lanjutData AI & LLM Generatif
SFT, RLHF, pasangan gesaan-respons, kedudukan keutamaan manusia dan set data RAG yang disampaikan oleh pakar subjek untuk meningkatkan ketepatan, mengurangkan halusinasi dan menyelaraskan tingkah laku model.
→ Ketahui lebih lanjutPengesahan & Penilaian Data
Pengesahan manusia-dalam-gelung, audit bias dan keadilan, dan penanda aras kualiti untuk mengukur dan meningkatkan ketepatan model sebelum dan selepas penggunaan.
→ Ketahui lebih lanjutSet Data Luar Rak
Set data pra-label yang sedia untuk digunakan daripada katalog data kami — 30 juta+ rekod perubatan yang dinyah-identifikasi, 70,000+ jam pertuturan dan senario AI fizikal.
Terokai katalog data →Data AI & Robotik Fizikal
Anotasi LiDAR dan awan titik, gabungan sensor, kotak sempadan 3D, trajektori robot dan senario tugas dunia sebenar yang melatih mesin autonomi, robot dan AI yang diwujudkan.
Lihat AI fizikal & robotik →Setiap Modaliti, Satu Rakan Kongsi
Data Latihan AI mengikut Jenis Data
Bagi setiap modaliti, kami melakukan kedua-dua bahagian kerja — mendapatkan data mentah yang tidak dapat anda temui di rak dan melabelkannya mengikut standard yang diperlukan oleh model anda. Satu rakan kongsi, satu proses QA, daripada pengumpulan hingga anotasi hingga penghantaran.
Pengumpulan Data & Anotasi Teks
Kami mengumpul: teks dan dokumen khusus domain — nota klinikal, kontrak, transkrip sembang dan sokongan serta set gesaan-respons yang ditulis oleh pakar yang telah disahkan dalam 65+ bahasa.
Kami memberi anotasi: NER, sentimen, pengelasan niat, pemautan entiti dan penandaan dokumen yang menukar teks tidak berstruktur kepada data latihan NLP dan LLM.
Koleksi dan Anotasi Pertuturan & Audio
Kami mengumpul: pertuturan skrip, spontan dan pusat panggilan yang dirakam oleh penutur asli merentasi 65+ bahasa, loghat, dialek dan persekitaran akustik sebenar.
Kami memberi anotasi: transkripsi, diarisasi dan ID penutur, pengecapan masa, pelabelan emosi dan niat untuk ASR, pembantu suara dan AI perbualan.
Perkhidmatan Pengumpulan & Anotasi Imej
Kami mengumpul: Set data imej tersuai yang dirakam mengikut spesifikasi anda — wajah dan biometrik, dokumen dan resit, rak runcit, pengimejan perubatan dan casing tepi dalam pencahayaan dan geografi yang akan dipenuhi oleh model anda.
Kami memberi anotasi: Kotak sempadan 2D/3D, poligon, segmentasi semantik sempurna piksel, mercu tanda dan titik kunci.
Perkhidmatan Pengumpulan & Anotasi Video
Kami mengumpul: Rakaman berbilang kamera, CCTV, kamera pemuka dan rakaman dalam kedai yang egosentrik dan dirakam oleh rangkaian penyumbang global merentasi senario yang telah ditetapkan dan yang tidak dijangka.
Kami memberi anotasi: Penjejakan objek bingkai demi bingkai, anggaran aktiviti dan posisi serta pengelasan peristiwa untuk robotik, pemanduan autonomi, sukan dan AI video runcit.
AI Fizikal, Robotik & Data Sensor
Kami mengumpul: tangkapan berbilang sensor daripada persekitaran sebenar — LiDAR, kedalaman, IMU, tangkapan gerakan VR, teleoperasi dan trajektori robot merentasi 1,400+ senario tugas dan 9 persekitaran.
Kami memberi anotasi: Kotak sempadan 3D, segmentasi titik-awan, penjajaran gabungan sensor dan pelabelan bahasa penglihatan untuk AI yang diwujudkan.
Penjanaan & Pengesahan Data Sintetik
Kami menjana: teks sintetik, imej dan data sensor yang mewakili pengumpulan dunia sebenar yang terhad, sensitif atau tidak selamat untuk dipentaskan — peristiwa yang jarang berlaku, kes pinggir ekor panjang dan domain yang terhad privasi.
Kami mengesahkan: ulasan manusia, pemeriksaan bias dan set campuran sebenar-tambah-sintetik supaya kualiti kekal dalam pengeluaran.
Kepakaran Manusia untuk AI Moden
Data Latihan AI & LLM Generatif
Membina atau memperhalusi model bahasa yang besar memerlukan lebih daripada sekadar teks mentah. Shaip memberikan kepakaran manusia yang menjadikan model generatif tepat, selamat dan sejajar.
Penalaan halus yang diselia (SFT)
Pasangan gesaan-respons berkualiti tinggi yang ditulis oleh pakar domain.
Kedudukan RLHF & keutamaan
Maklum balas manusia dan perbandingan tindak balas untuk menyelaraskan tingkah laku model.
RAG & data tambahan yang boleh diambil semula
Pangkalan pengetahuan domain, pemecahan dokumen dan pasangan pertanyaan-petikan yang mendasari respons model dalam kandungan anda sendiri.
Penilaian model
Pengauditan halusinasi, pemeriksaan fakta dan penanda aras kualiti.
Data pakar domain
Gesaan, respons dan penilaian yang dikarang oleh pakar yang telah ditapis dalam penjagaan kesihatan, perundangan, kewangan dan banyak lagi.
Liputan berbilang bahasa
Anotator pakar merentasi 65+ bahasa dan domain khusus.
Data untuk Dunia Nyata
Data Latihan AI & Robotik Fizikal
Robot, kenderaan autonomi dan AI yang diwujudkan belajar daripada dunia fizikal — dan itu memerlukan data 3D, sensor dan gerakan yang tepat. Shaip menyediakan set data dunia sebenar multimodal merentasi lebih 1,400 senario tugas dan 9 persekitaran untuk melatih persepsi, navigasi dan manipulasi.
Anotasi LiDAR & awan titik
Kotak sempadan 3D, segmentasi semantik dan penjejakan objek pada awan titik.
Gabungan sensor
Kamera sejajar, LiDAR, radar dan data IMU untuk persepsi berbilang sensor yang mantap.
Trajektori & teleoperasi robot
Data demonstrasi, tindakan dan manipulasi untuk pembelajaran peniruan dan peneguhan.
Aktiviti manusia & anggaran postur
Titik kekunci, gerak isyarat dan data interaksi untuk kerjasama manusia-robot yang selamat.
Pengesanan & penjejakan objek
Pengesanan, pengelasan dan penjejakan berbilang objek merentasi strim kamera dan sensor untuk persepsi masa nyata.
Senario tugas dunia sebenar
1,400+ senario merentasi 9 persekitaran untuk gudang, rumah, perindustrian dan robotik luar.
Mengapa Memilih Shaip sebagai Penyedia Data Latihan AI Anda
Keupayaan Pengumpulan Data
Buat, susun dan kumpulkan set data tersuai (teks, ucapan, imej, video) dari seluruh dunia berdasarkan garis panduan tersuai.
Tenaga Kerja Global Fleksibel
Manfaatkan lebih 10,000 tenaga kerja global dalaman dan lebih 500 ribu penyumbang bertauliah berskala ramai. Kapasiti dan kecekapan tenaga kerja masa nyata.
Kualiti
Platform proprietari & tenaga kerja mahir kami menggunakan pelbagai kaedah kawalan kualiti untuk memenuhi atau melebihi standard kualiti.
Kepelbagaian, Tepat & Cepat
Proses kami menyelaraskan proses pengumpulan melalui pengagihan tugas yang lebih mudah & penangkapan data terus daripada aplikasi & web.
Keselamatan Data
Jaga kerahsiaan data lengkap dengan menjadikan privasi sebagai keutamaan kami. Kami memastikan format data dikawal dan dipelihara oleh dasar.
Kitaran hayat penuh
Satu rakan kongsi merentasi pengumpulan, anotasi, penalaan halus AI generatif dan penilaian
Langkah-langkah untuk Copytrade
Cara Kami Menyampaikan Data Latihan Anda
Keselamatan & Pematuhan


Beritahu kami tentang inisiatif AI anda yang seterusnya.
Daripada pengumpulan data kepada anotasi, pelesenan dan pengesahan — kami akan membantu anda memasuki pasaran dengan lebih pantas, dengan data yang boleh anda percayai.
Hubungi KamiSoalan-soalan yang kerap ditanya (FAQ)
1. Apakah data latihan AI?
Data latihan AI ialah data berlabel atau berstruktur yang digunakan untuk mengajar model pembelajaran mesin bagi mengenal pasti corak dan membuat ramalan. Ia boleh jadi teks, audio, imej, video atau data multimodal, dan kualitinya secara langsung menentukan ketepatan model.
2. Apakah kegunaan data latihan AI?
Ia digunakan untuk melatih, memperhalusi dan menilai model AI dan pembelajaran mesin — termasuk sistem penglihatan komputer, pengecaman pertuturan, AI perbualan dan model bahasa yang besar.
3. Apakah jenis data latihan AI yang disediakan oleh Shaip?
Shaip menyediakan teks, pertuturan dan audio, imej, video, multimodal, AI/sensor fizikal dan data sintetik — melalui pengumpulan, anotasi dan pelabelan, penalaan halus LLM dan perkhidmatan pengesahan.
4. Bagaimanakah Shaip memastikan kualiti data latihan?
Setiap projek menggunakan anotator pakar domain dan QA berbilang peringkat, manusia-dalam-gelung termasuk semakan konsensus, pensampelan dan pemeriksaan bias, dengan pelaporan kualiti yang diukur.
5. Apakah bahasa dan negara yang diliputi oleh Shaip?
Shaip menyokong lebih 65 bahasa dan sumber data yang dipersetujui dari lebih 60 negara, dengan rangkaian lebih 1,000 pakar data yang telah disahkan.
6. Adakah data saya selamat dan pensijilan apakah yang dipegang oleh Shaip?
Ya. Shaip diperakui ISO 27001 dan ISO 9001:2015, diaudit SOC 2 Jenis II, mematuhi HIPAA dan sedia GDPR/CCPA, dengan penyamaran PII, penyulitan dan akses berasaskan peranan.
7. Bolehkah Shaip menyediakan data latihan untuk LLM dan AI generatif?
Ya. Shaip menawarkan penalaan halus yang diselia (SFT), RLHF, kedudukan keutamaan manusia, set data RAG, pasangan gesaan-respons dan penilaian model untuk model bahasa yang besar dan AI generatif.
8. Adakah Shaip menyediakan data latihan AI fizikal dan robotik?
Ya. Shaip menyediakan data latihan AI fizikal dan robotik termasuk anotasi LiDAR dan awan titik, gabungan sensor, kotak sempadan 3D, trajektori robot, data SLAM dan navigasi serta senario tugas dunia sebenar merentasi lebih 1,400 senario dan 9 persekitaran untuk sistem autonomi dan AI terwujud.
9. Bagaimanakah harga data latihan AI?
Harga bergantung pada jenis data, jumlah, kerumitan anotasi, bahasa dan pemulihan. Shaip menyediakan sebut harga tersuai selepas skop kes penggunaan anda — minta sebut harga percuma untuk bermula.
10. Adakah Shaip menawarkan set data sedia ada?
Ya. Set data pra-label yang sedia untuk digunakan boleh didapati daripada katalog data Shaip, termasuk rekod perubatan, pertuturan berbilang bahasa dan senario AI fizikal, untuk pelesenan.
11. Bagaimanakah saya boleh bermula dengan Shaip?
Hubungi Shaip dengan kes penggunaan anda untuk membuat skop percubaan. Kami menyelaraskan garis panduan dan sasaran kualiti, kemudian menghantar sampel atau kelompok percubaan sebelum penskalaan.
